


 400-8765-888
 kefu@makeding.com


仅剩:

发布时间:2021-04-21 10: 36: 11
作为广受数据分析师青睐的一款数据统计和分析软件,IBM SPSS Statistics中有全面的数据分析方法,今天我们要介绍的是它的聚类分析中的快速聚类分析。
一、方法概述
聚类分析是将研究对象按照一定的标准进行分类的方法,分类结果是每一组的对象都具有较高的相似度,组间的对象具有较大的差异。
这类分析方法多用于对于数据样本没有特定的分类依据的情况,IBM SPSS Statistics会通过对数据的观察为用户做出较为完善的分类。
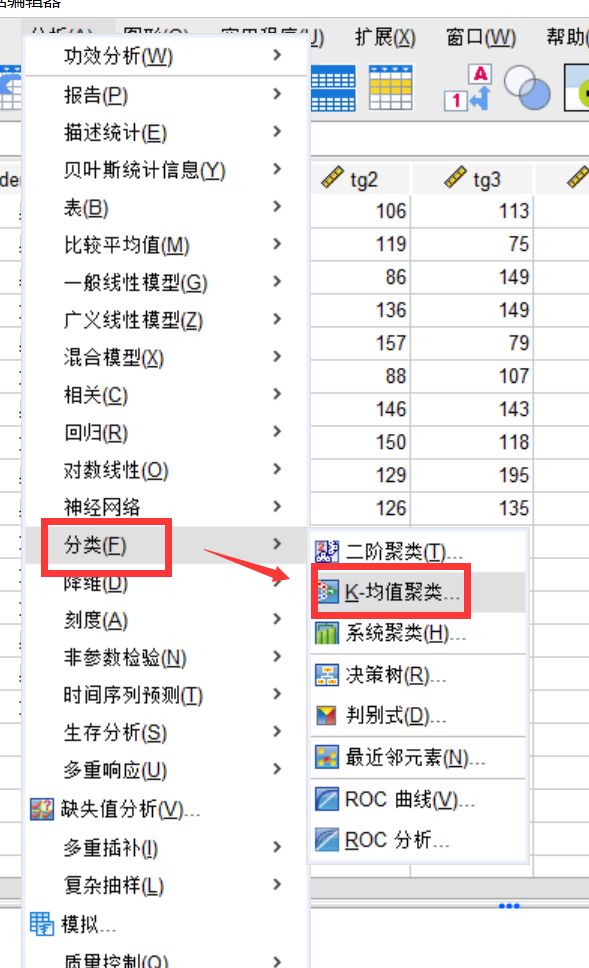
快速聚类是聚类分析的一种,使用到的功能在“分析”——“分类”中的“K-均值聚类”。
二、案例分享
1.样本数据
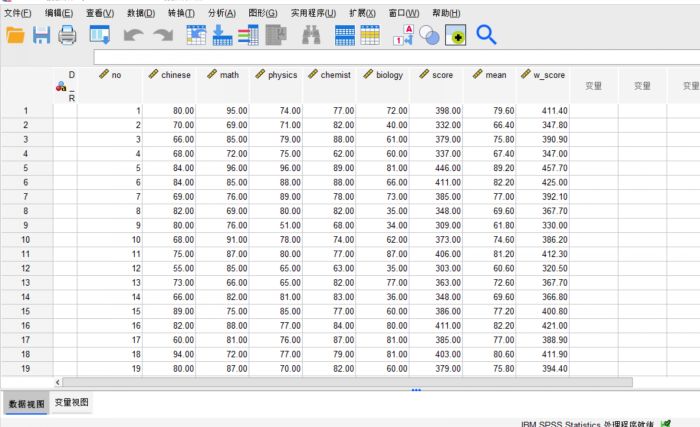
我们这里选择的数据样本是一部分学生的各科期末成绩,使用快速聚类方法可以分析各个学生成绩分布的差异和共性。
2.变量设置
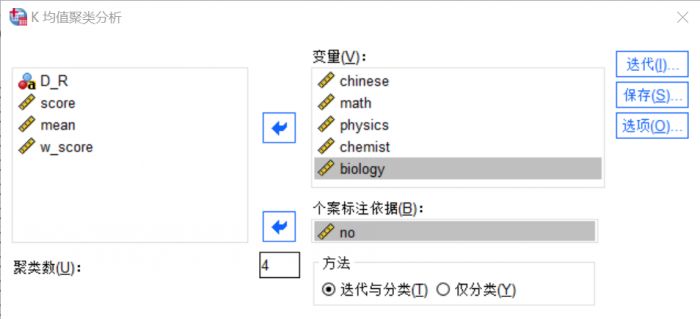
我们将学生的所有单科成绩作为分析变量,移入到“变量”窗口中,将学生的编号变量移入到下侧的“个案标记依据”窗口。
聚类数设置的是分类的数目,这个需要根据数据样本的特点来设置,我们这里设置为4类。
聚类方法有两类,即迭代和分类,前者较为复杂,会在分析过程中不断移动凝聚点,后者则始终使用初始凝聚点,我们选择两类都有的第一种分析方法。
3.聚类中心
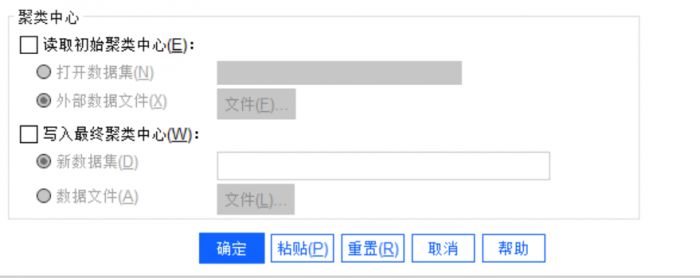
用户可以选择从外部文件或数据文件中写入或读取聚类中心,本案例中我们不使用这个功能。
4.迭代设置
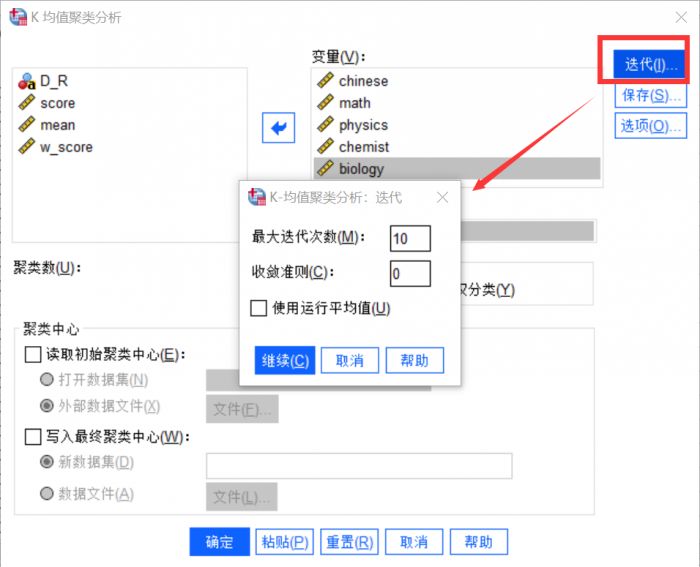
我们可以设置迭代的终止条件,即到达设定的最大值后将停止迭代分析,输出聚类分析结果。
收敛性标准设置的是凝聚点改变的最大距离小于初始凝聚点的比例,小于设定值时,也会停止迭代,输出结果。
使用运行均值表示每次观测后都重新计算凝聚点,这些设置保持默认即可。
5.保存
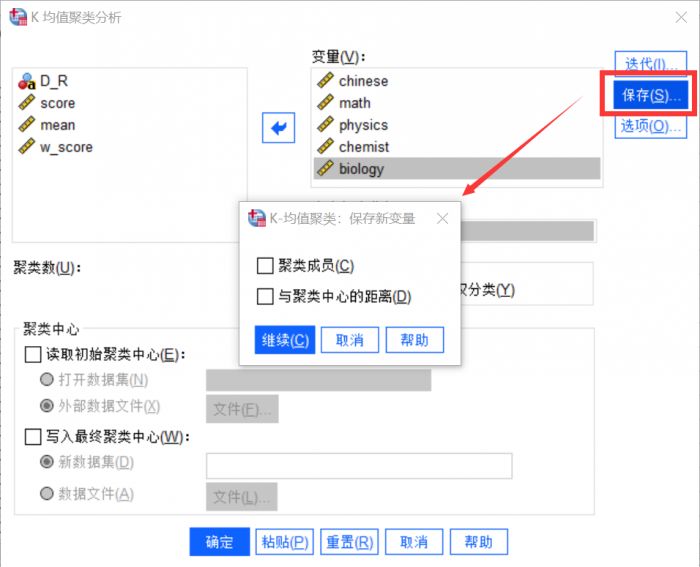
这是用来设置保存形式的,勾选“聚类成员”将保存SPSS的分类结果,勾选“与聚类中心的距离”将保存观测值和所属类别的欧氏距离,我们不做设置。
6.选项
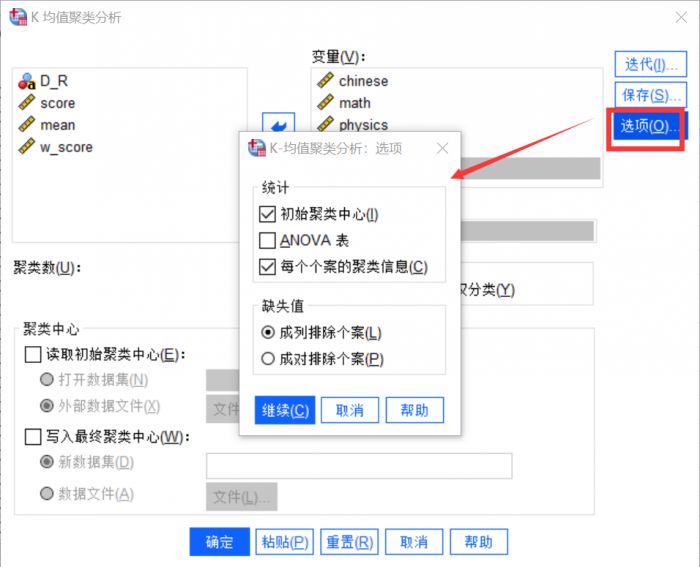
这个对话框设置的是输出的统计量和个案缺失处理方法,勾选“初始聚类中心”和“每个个案的聚类信息”。
7.结果输出
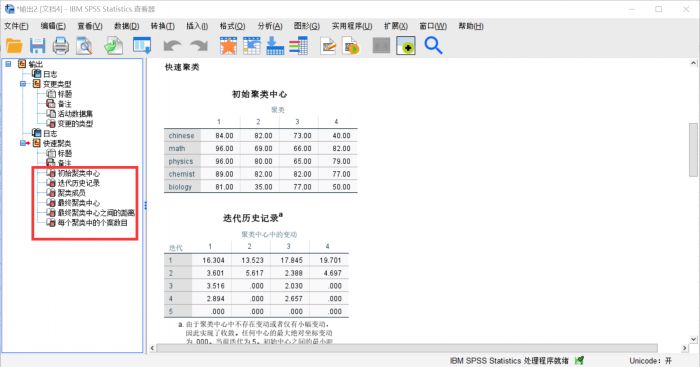
在输出日志中可以看到,这些学生根据他们的单科成绩被分成了四类,SPSS输出了多个表格,包括初始聚类中心、迭代历史记录、聚类成员、最终聚类中心、最终聚类中心之间的距离和每个聚类中的个案数目,完整详细,可信度较高。
三、小结
使用IBM SPSS Statistics进行快速聚类的方法和案例分享就是这么多啦,这是一个较为常用的分类分析法,适用程度很高,希望可以对大家有所帮助!
如果您对SPSS也有兴趣,欢迎进入IBM SPSS Statistics中文网站下载试用!
作者:参商
展开阅读全文
︾
读者也喜欢这些内容:

SPSS事后比较怎么选择 SPSS事后比较怎么看
SPSS作为一款优秀的数据统计分析软件,软件内有许多的数据统计分析方法,可以帮助统计人员为研究项目提供可靠、有价值的数据,同时SPSS还可以帮助统计人员清理研究数据中的冗余数据,为研究结果的准确性提供了保障。今天要给大家介绍的是有关SPSS事后比较怎么选择,SPSS事后比较怎么看的相关内容。...
阅读全文 >
SPSS怎么进行Logistic回归 SPSS Logistic回归分类结果不准确怎么办
在数据分析中,Logistic回归常常作为处理二分类因变量的方法,应用场景广泛。使用SPSS进行Logistic回归时,很多朋友常面临分类结果不准确的问题。今天我们将会详细介绍关于SPSS怎么进行Logistic回归,SPSS Logistic回归分类结果不准确怎么办的相关问题。...
阅读全文 >
SPSS多层线性模型如何构建 SPSS多层线性模型层级变量设置
每当在进行数据分析时,许多小伙伴可能都会遇到构建多层线性模型的情况。构建多层线性模型能扩大已测量的数据样本,使数据涵盖更多内容,进而更加有说服力。而在进行多层线性模型构建时,一款好用的数据分析软件是不可缺少的,这里给大家介绍我自己常用的SPSS数据分析软件,同时以它为例向大家介绍SPSS多层线性模型如何构建,SPSS多层线性模型层级变量设置的具体内容。...
阅读全文 >
SPSS显著性小于0.001的意义 SPSS显著性大于0.05怎么办
在使用SPSS软件进行数据分析工作的过程中,得到的显著性水平分析结果具有极为重要的作用。它能够帮助我们衡量变量之间是否存在真实的关联,或者不同组别数据之间是否存在实质性的差异。今天我们就一起来探讨关于SPSS显著性小于0.001的意义,SPSS显著性大于0.05怎么办的问题。...
阅读全文 >
