


 400-8765-888
 kefu@makeding.com


仅剩:

发布时间:2021-09-18 14: 08: 29
IBM SPSS Statistics的K均值聚类分析,是一种采用欧式距离作为分类指标的迭代聚类分析方法。其优点是操作简单,运算速度快,但由于其聚类原理是将欧式距离相似的数据归为一个类别,因此需采用连续型的数据变量。
接下来,我们通过实例来演示一下K均值聚类分析。
一、数据准备
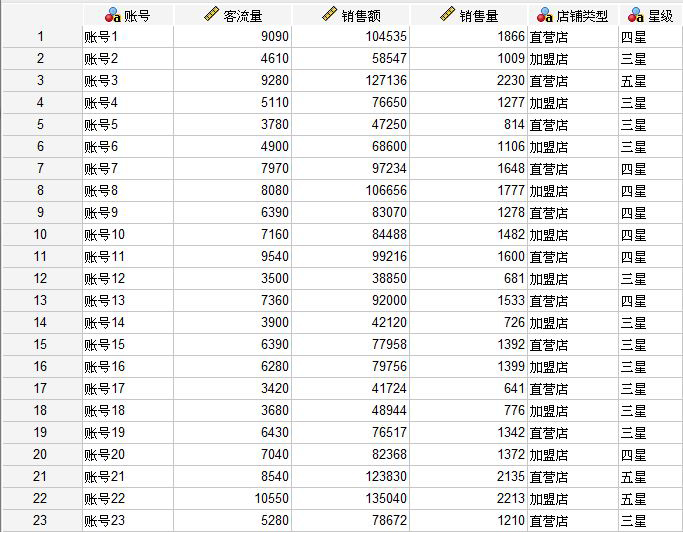
本例使用的是一组店铺的销售数据,包含客流量、销售额与销售量三个连续型变量。我们会使用到以上三个连续变量对数据个案进行K均值聚类分析。
二、K均值聚类参数设置
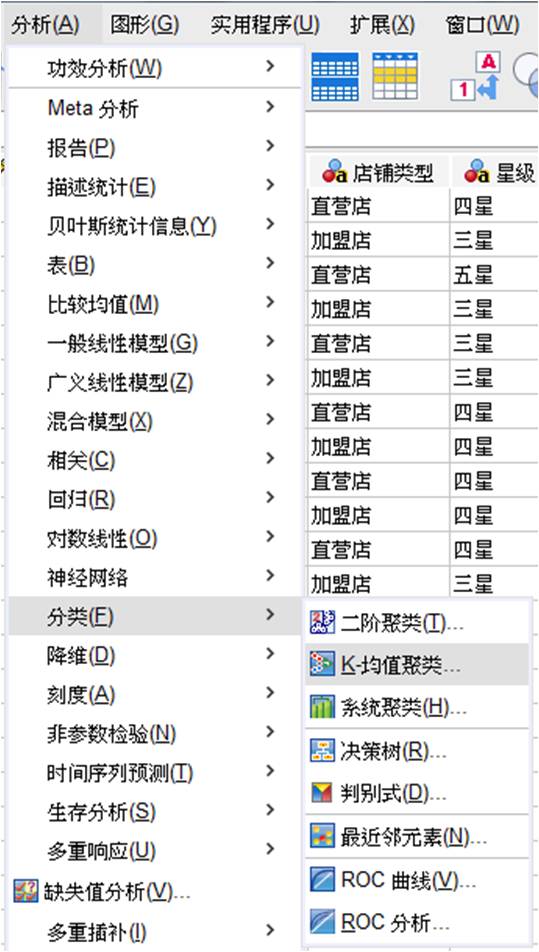
K均值聚类分析是SPSS分类分析法中的一种,由于其运算的快速性,也被称为“快速聚类”。
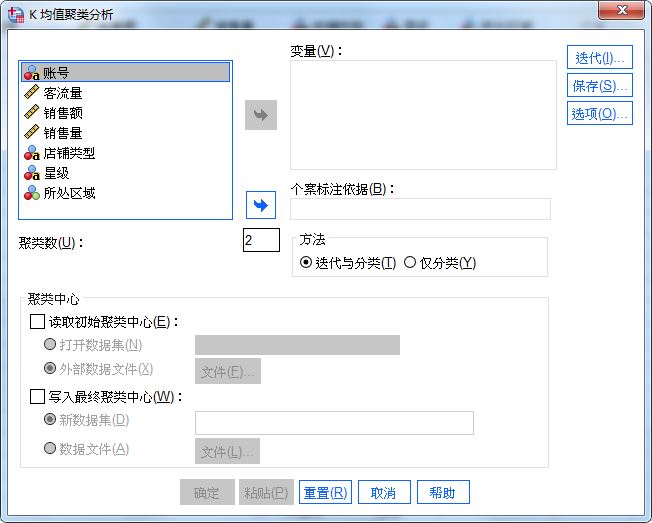
如图3所示,K均值聚类分析设置面板包含变量、聚类中心等设置参数。
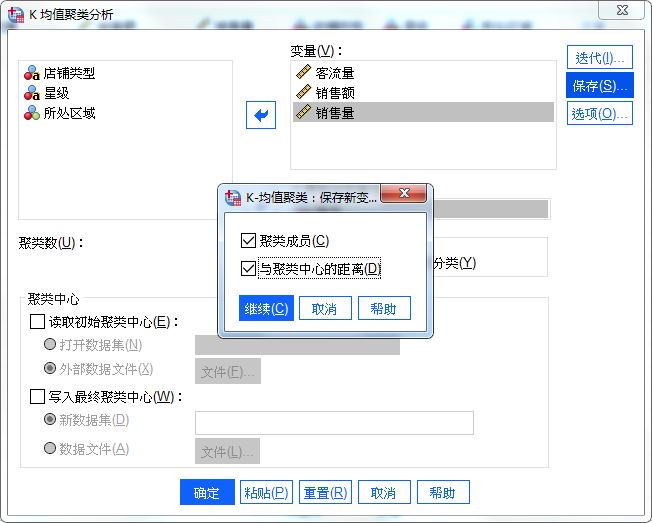
按照数据分析目的,如图4所示,我们需将客流量、销售额、销售量添加为变量,然后再单击右侧的“保存”按钮,保存“聚类成员”与“与聚类中心的距离”两个新变量。
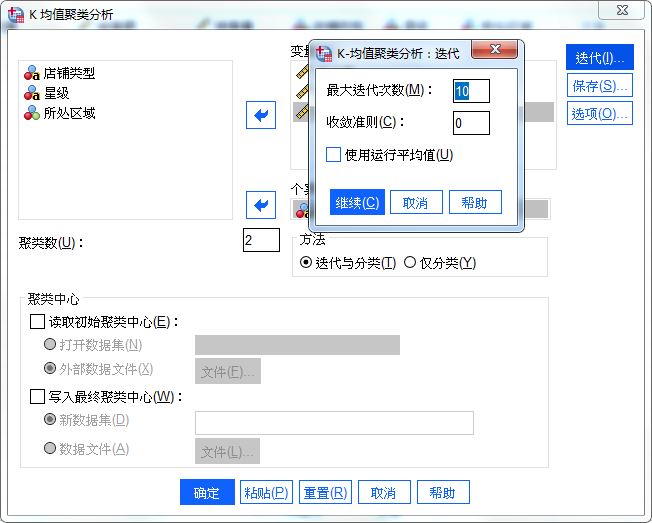
接着,打开“迭代”设置,设置最大迭代次数,一般按照默认即可,如果默认次数过小,应尽量调大。
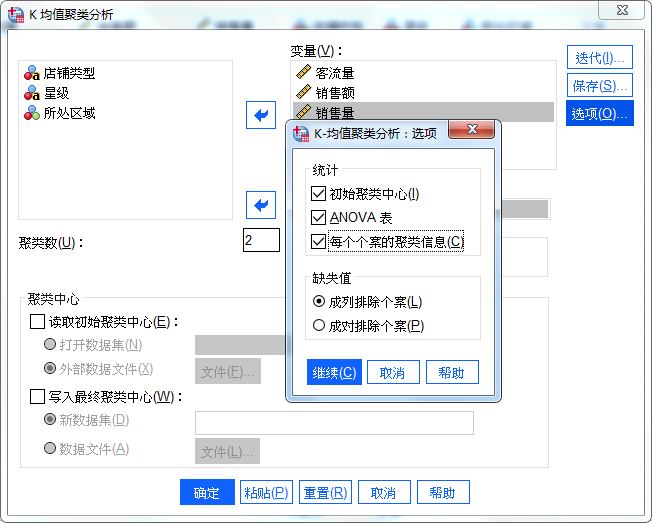
最后,设置分析的选项,如图6所示,勾选“初始聚类中心”与“每个个案的聚类信息”,以了解初始聚类与最终聚类的个案数目;勾选“ANOVA表”,检验分析的置信水平。
三、结果解读
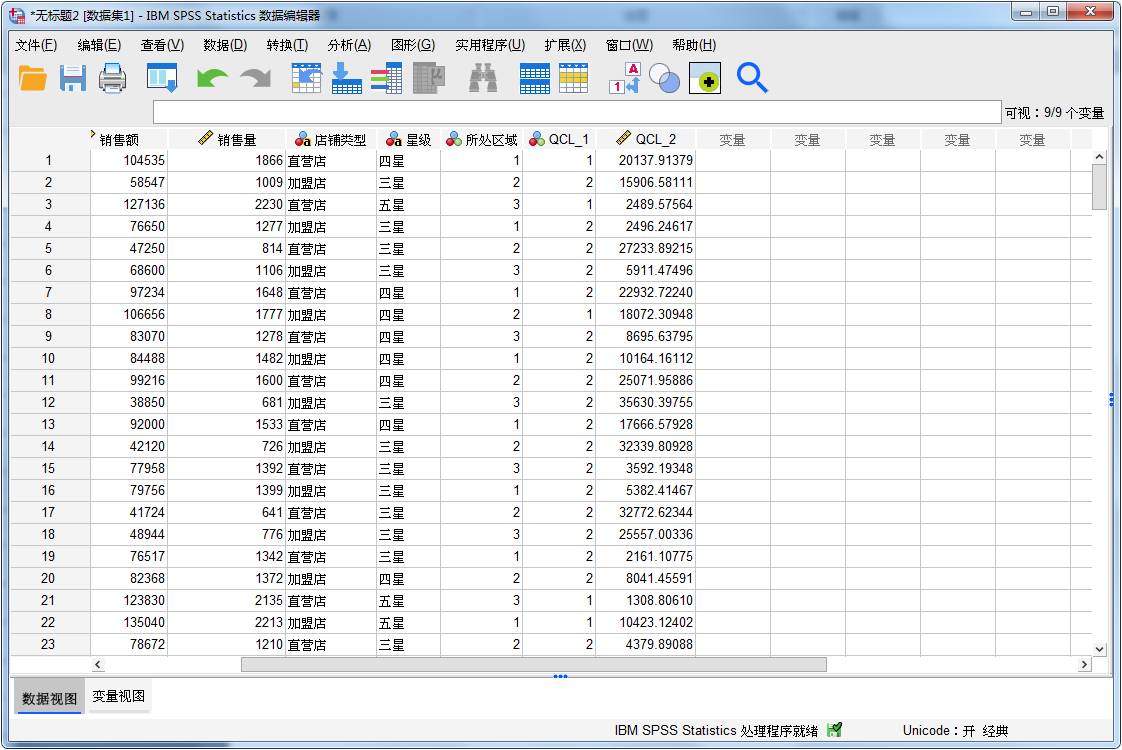
运行分析后,回到数据表,如图7所示,原数据表末端出现了两个新变量,分别是“聚类成员”与“与聚类中心的距离”。我们可以从中观察到每个个案所属的聚类,以及该个案与聚类中心的距离。
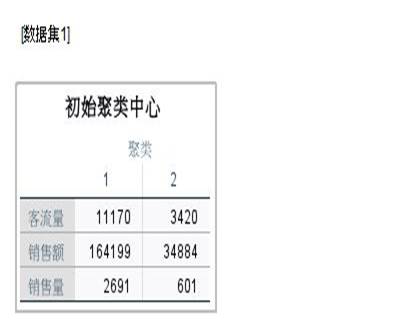
而从分析结果看到,SPSS初始设定了两个聚类。
而经过2次迭代运算后,最终聚类中心仍设定为两个不变。
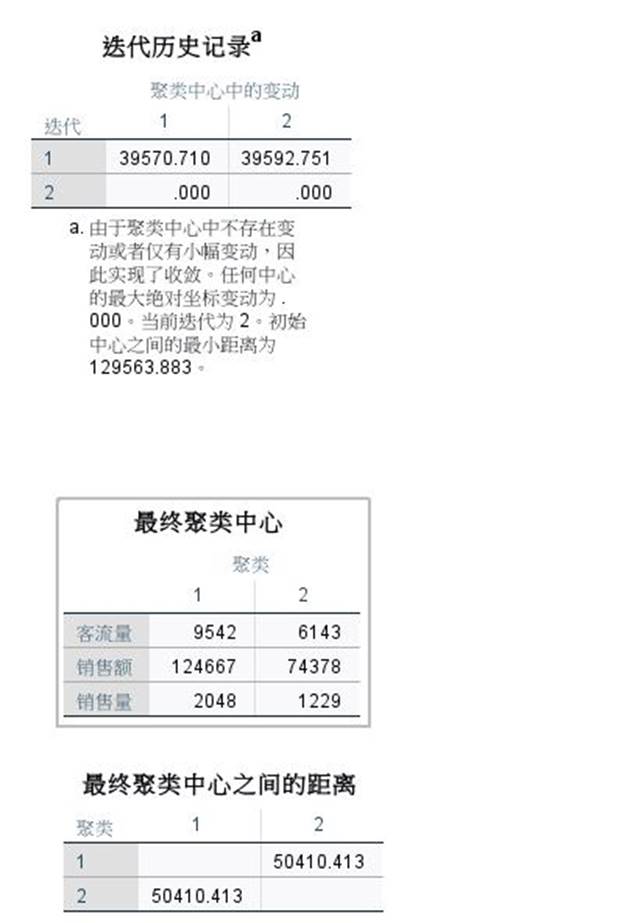
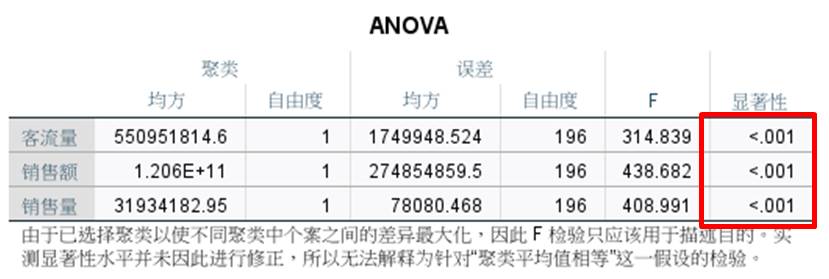
而从ANOVA分析表看到,客流量、销售额、销售量的显著性都小于0.001,说明这三个变量都能很好地区分各个分类。
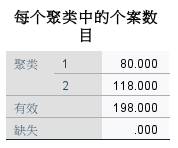
最后,从“每个聚类中的个案数目”可得到每一类别包含的个案数量。
四、小结
综上所述,K均值聚类分析,可利用欧式距离的测量,快速地将距离相似的个案归总为一个类别,但也要注意到的是,K均值聚类分析受异常值影响较大。
除K均值聚类,SPSS还提供了系统聚类、二阶聚类的分类方法,可前往SPSS中文网站获取更加系统的演示分享。
作者:泽洋
展开阅读全文
︾
读者也喜欢这些内容:
SPSS随机分组步骤 SPSS选择个案怎么选择多项
为了确保样本组之间的随机性、公平性,有时候我们需要给数据重新弄分组。如果直接手动分组的话,容易因为不够随机性,而出现各种研究误差。所以,针对这种情况,我们可以用SPSS的功能来实现分组的随机性,比如用计算变量、重新编码这些方法。接下来,我们会介绍SPSS随机分组步骤,SPSS选择个案怎么选择多项的相关内容。...
阅读全文 >
SPSS如何做方差分析 SPSS方差分析结果显著性该怎么解释
在数据分析这个领域当中,许多小伙伴经常会遇到进行方差分析的操作。方差分析在数据统计中是一个常见的数据处理方式,主要用来检验数据样本的离散分布和稳定性情况。SPSS既能够帮助我们进行专业的方差分析,还可以得到数据的分析报告。接下来以SPSS为例,向大家介绍SPSS如何做方差分析,SPSS方差分析结果显著性该怎么解释的具体内容。...
阅读全文 >
SPSS怎么计算Z分数 SPSS标准化后原始值怎么还原
假设小明在期末考试中语文考了90分、数学考了85分,我们可以很轻易地比较出小明的语文分数是高于数学的,但是这就能说明他的语文比数学要好吗?显然不能,我们还需要比较小明所在班级的平均分,假如数学平均分为70标准差为10、语文平均分为82标准差为8,那么实际上小明的数学z分数为1.5,语文成绩为1.0,因此小明的数学成绩在班级中的排名是高于语文成绩在班级中的排名的,即实际上小明的数学成绩考得更好。Z分数就是这样帮助我们比较不同维度数据的一种统计工具。接下来我就给大家介绍一下SPSS怎么计算Z分数,SPSS标准化后原始值怎么还原。...
阅读全文 >
SPSS倾向性评分匹配如何操作 SPSS倾向性评分匹配结果分析
倾向性评分匹配是统计学中的一种数据处理方式,我们可以通过评分匹配优化数据在原始数据当中的排列方式,避免各种杂乱因素影响分析结果的准确性。今天我就以SPSS倾向性评分匹配如何操作,SPSS倾向性评分匹配结果分析这两个问题为例,来向大家讲解一下倾向性评分匹配的相关知识。...
阅读全文 >