- 首页
- 产品
- 下载
- 学生专享NEW
-
帮助中心
使用IBM SPSS Statistics的最近邻元素模型进行数据分析!
发布时间:2022-05-06 14: 18: 21
SPSS的最近邻元素分析是一种分类模型,它是根据个案间的相似性来对个案进行分类。简单来说就是相同个案相互靠近,不同个案相互远离。因此,可以通过判断样本距离哪个离中心点更近,进而判断样本数据属于哪个类别。本篇教程将教大家使用SPSS的最近邻元素模型对汽车行业数据进行数据分析,相信通过学习SPSS的最近邻元素模型,你将能够对各个领域数据分析。
一、 数据准备与数据预处理
为了用最近邻元素模型给大家演示数据分析,这里使用Kaggle实验室的car_sales数据集。主要通过添加两款新研制的车型进行数据分析,这两款预研车型技术指标主要包括Model、Priceinthousands、enginesize、horsepower、width、length、curbweight、fuelcapacity、fueleffciency等。
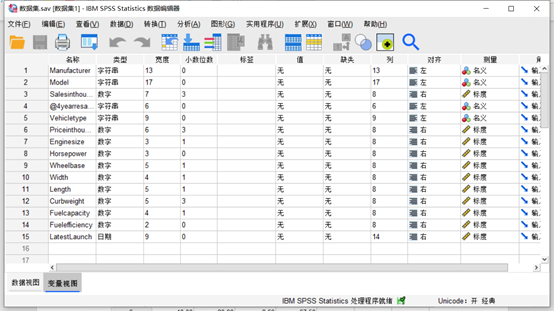
图1数据展示 为了对这款新研发的车型进行分析,这里在原数据添加这两个车型的新记录。
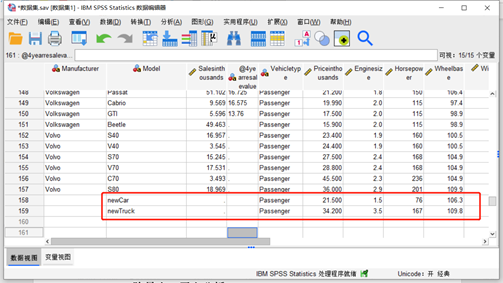
图2新增记录 为了对新记录添加特别关注的标记,因此这里将添加一个名为focal的新变量。点击SPSS顶部菜单栏“转换”-“计算变量”,打开计算变量窗口,目标变量命名为focal,并在数字表达式输入any(Model,'newCar','newTruck')。这个函数表达式意思是Model变量值为'newCar'或者'newTruck',则focal为1,否则为0.
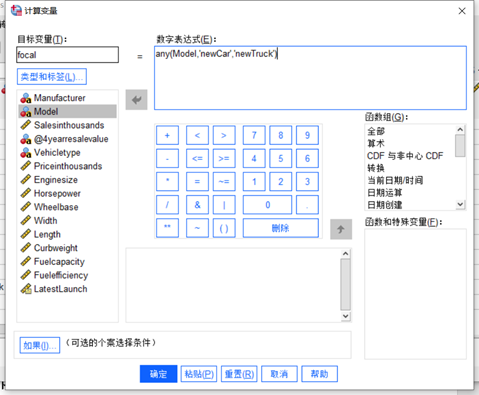
图3新增变量focal 同样通过计算变量方式添加变量partition,用于区分训练数据集和测试数据集,表达式为1-any(Model,'newCar','newTruck')。Partition>0,则为训练数据,否则为测试数据。
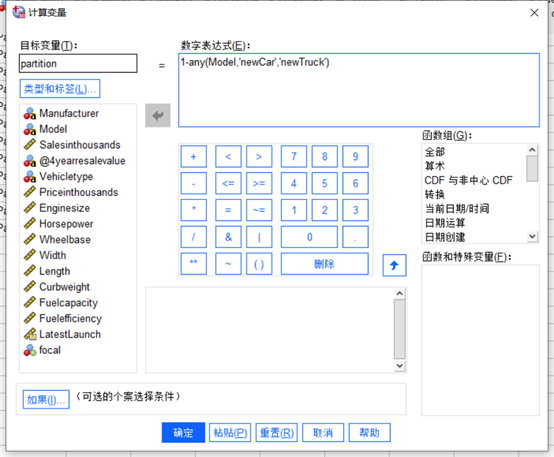
图4新增变量partition 二、最近邻元素模型分析
由于篇幅有限,这里仅展示预估汽车类型。点击SPSS顶部菜单栏“分析”-“分类”-“最小邻元素”。点击顶部“变量”项目进行设置,将vehicletype加载到目标文本框,9个指标加载到特征文本框,focal加载到焦点个案,Model加载到个案标签。
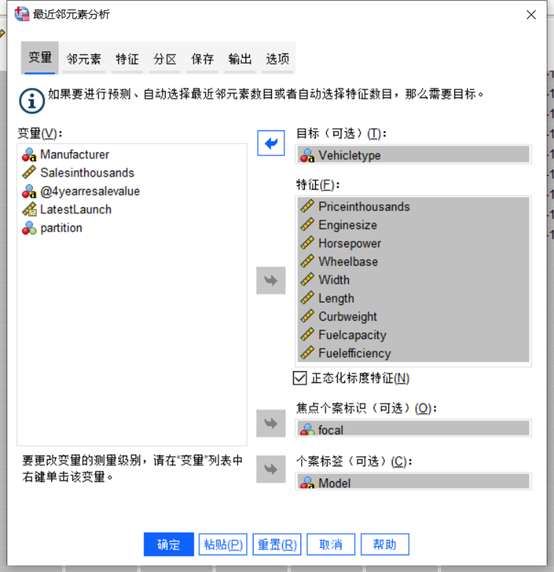
图5最近邻元素分析 点击最近邻元素分析顶部“邻元素”,将k值设置为3,并且勾选计算距离时按重要性对特征进行加权。
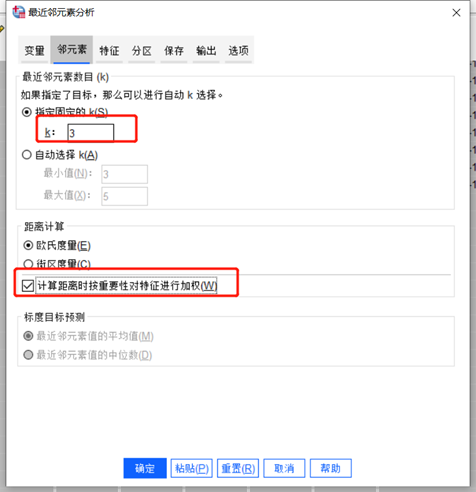
图6邻元素 点击最近邻元素分析顶部“分区”,训练和坚持分区选择使用变量来分配个案,并且将partition加载到分区变量文本框。
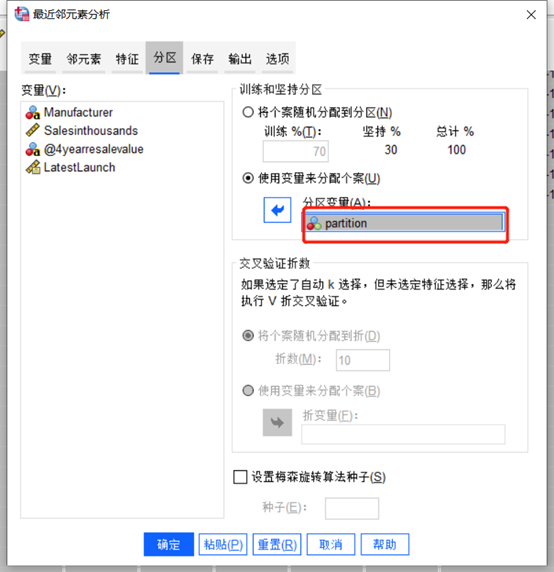
图7分区 三、结果分析
可以看到对于预估汽车类型结果,数据添加了一个预测值的变量,可以看到对新车的预测比较准确,并且生成了一个预估变量空间图型。
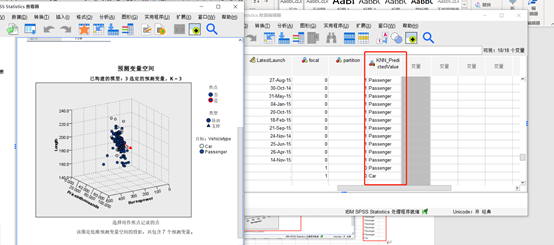
图8预估结果 四、小结
以上是利用SPSS最近邻元素模型对汽车行业数据进行分析,相信通过从数据准备和预处理,再到利用最近邻元素模型分析,最后到结果分析,你已经对该模型有一定了解,并且能够简单使用到各个领域。
作者:独行侠
展开阅读全文
︾
标签:IBM SPSS Statistics,spss,IBM SPSS
读者也访问过这里:热门文章SPSS数据分析显著性差异分析步骤 SPSS显著性差异分析结果怎么看数据的显著性差异分析主要有三种方法,分别是卡方检验、T检验和方差分析。这三种方法都有具体的数据要求:卡方检验是对多个类别的数据进行分析,T检验是对两组数据进行分析,方差分析是对多组数据进行检验。下面,小编具体说明一下SPSS数据分析显著性差异分析步骤,SPSS显著性差异分析结果怎么看。2022-01-07实践SPSS单因素方差分析之检验结果解读在《实践SPSS单因素方差分析之变量与检验方法设置》一文中,我们已经详细地演示了IBM SPSS Statistics单因素方差分析方法的变量选择以及相关的选项、对比设置。2021-01-11spss如何做显著性分析 spss显著性差异分析怎么标abc在统计分析中,显著性分析是分析相关因素之间是否存在显著影响关系的关键性指标,通过它可以说明分析结论是否由抽样误差引起还是实际相关的,可论证分析结果的准确性。下面大家一起来看看用spss如何做显著性分析,spss显著性差异分析怎么标abc。2022-03-14SPSS回归分析中的f值是什么 SPSS回归分析F值在什么范围合适回归分析中以R表示相关性程度的高低,以F评价回归分析是否有统计学的意义,使用IBM SPSS Statistics进行回归分析,可以非常快速的完成R,F的计算,并且给出回归曲线方程,那么,SPSS回归分析中f值是什么?SPSS回归分析F值在什么范围合适,本文结合实例向大家作简单的说明。2022-07-22SPSS多元logistic回归分析的使用技巧回归分析是数据处理中较为常用的一类方法,它可以找出数据变量之间的未知关系,得到较为符合变量关系的数学表达式,以帮助用户完成数据分析。2021-04-26SPSS相关性分析结果怎么看相关性分析是对变量或个案之间相关度的测量,在SPSS中可以选择三种方法来进行相关性分析:双变量、偏相关和距离。2021-04-23最新文章SPSS个案排序和个案排秩的区别 SPSS个案排秩怎么操作我们在使用SPSS进行数据整理与统计分析时,个案排序和个案排秩是两种十分常用的整理方式,但很多使用者容易将二者混淆。接下来我将为大家介绍:SPSS个案排序和个案排秩的区别,SPSS个案排秩怎么操作的相关内容。2026-09-02SPSS怎么进行对数转换 SPSS取对数是ln还是log对于经常需要与数据分析和数学计算打交道的小伙伴来说,想必对于对数转换这个概念应该不会感到陌生。在处理数据的过程中,如果遇到了方差不齐或者变量之间呈现非线性关系的时候,就需要用到对数转换的分析方式对数据样本进行处理,而在对数转换的过程中,ln和log作为对数计算式,在这里有关键的作用。下面以SPSS为例,给大家SPSS怎么进行对数转换,SPSS取对数是ln还是log的具体内容。2026-09-02SPSS K均值聚类怎样评估 SPSS K均值聚类轮廓系数应如何解读在数据分析的领域中,聚类分析是一项重要的数据分析操作。它可以帮助我们把同类型的数据样本一并进行分析,减少同类样本的分析次数,对数据进行快速处理。而K均值聚类作为常规聚类分析法的一类延伸,是把数据组中的样本划分为K个预定义且不重叠的数据组(也称为簇),K指的就是其中数据簇的数量。下面以SPSS为例,给大家介绍SPSS K均值聚类怎样评估,SPSS K均值聚类轮廓系数应如何解读的具体内容。2026-09-02SPSS正态性检验怎么做 SPSS正态性检验结果偏离正态如何处理正态性检验是数据分析中的一个重要环节。例如我们在分析一组数据样本是否服从正态分布时(呈现明显的单峰分布),就可以采用正态性检验对数据进行处理。但是我们在进行正态性检验分析的时候,可能也会遇到正态性检验结果偏离正态分布的结果,这种情况下就需要我们对数据样本或者统计方法进行调整和修改。下面以SPSS为例,介绍SPSS正态性检验怎么做,SPSS正态性检验结果偏离正态如何处理的具体内容。2026-09-02SPSS方差齐性检验在哪设置 SPSS方差齐性检验不通过怎么办方差齐性检验(也称为F检验)是数据分析中一项不可缺少的环节,在许多的场景中都有着广泛的应用。例如有一组城市和农村的学校学生学习成绩的数据,两组方差相等代表城乡学生成绩离散程度一致,说明城乡环境对成绩的波动影响相近。而我们在进行方差齐性检验的时候,可以用到SPSS软件进行专业的数据分析。下面给大家介绍SPSS方差齐性检验在哪设置,SPSS方差齐性检验不通过怎么办的具体内容。2026-09-02SPSS数据单位如何输入 SPSS如何导出部分数据的结果在SPSS软件里面,我们通常是输入纯数值做运算的。因为它的数据表跟Excel类似,都没有输入单位的功能。但在一些研究中,比如分析人流量与销售额的关系时,我们可能要加入单位,才能更好地说明数据。那么,怎么才能在SPSS数据表里面体现单位?接下来,本文会给大家介绍SPSS数据单位如何输入,SPSS如何导出部分数据的结果的相关内容。2026-09-02读者也喜欢这些内容:
-
SPSS显著性小于0.001的意义 SPSS显著性大于0.05怎么办
在使用SPSS软件进行数据分析工作的过程中,得到的显著性水平分析结果具有极为重要的作用。它能够帮助我们衡量变量之间是否存在真实的关联,或者不同组别数据之间是否存在实质性的差异。今天我们就一起来探讨关于SPSS显著性小于0.001的意义,SPSS显著性大于0.05怎么办的问题。...
阅读全文 >
-
SPSS趋势分析怎么做 SPSS趋势分析时间序列怎么做
当我们想要对一系列有关时间变化的数据进行纵向的分析,推荐使用SPSS趋势分析的方法,这种方法可以应用于多类场景的数据分析,例如旅游景点的淡旺季客流量、农产品的四季变化产量等。本文以SPSS趋势分析怎么做,SPSS趋势分析时间序列怎么做这两个问题为例,给大家介绍一下SPSS趋势分析的相关知识。...
阅读全文 >
-
SPSS数据筛选好用吗 SPSS数据筛选怎么进行
在数据分析领域,如果收集的数据是为了按照一定标准或者类别来进行区分,我们可以尝试去运用SPSS的数据筛选功能,例如进行海量问卷调查的年龄段分层、地区划定、性别划分等等。本文以SPSS数据筛选好用吗,SPSS数据筛选怎么进行这两个问题为例,带大家了解一下SPSS数据筛选的知识。...
阅读全文 >
-

SPSS数据视图都是问号怎么办 SPSS数据视图怎么输入文字
SPSS数据统计分析软件的应用领域很广泛,像是教育学、经济学、社会学、医疗等领域都有涉及,也是因为应用的领域广,所以使用SPSS的统计人员也比较多。不过在使用SPSS的时候,也会遇到一些问题,下面给大家介绍SPSS数据视图都是问号怎么办,SPSS数据视图怎么输入文字的相关内容。...
阅读全文 >
-

 400-8765-888
 kefu@makeding.com