


 400-8765-888
 kefu@makeding.com


仅剩:

发布时间:2021-06-15 15: 09: 59
在上节《在SPSS中安装加权kappa计算插件》中,我们已经成功地在SPSS软件中安装了加权Kappa插件,本文将带大家继续深入了解这一插件的使用场景和使用方式。
一、生成交叉表
我们下面要进行使用的数据如图1所示,该数据共50条记录,表示了两名医生对疾病严重程度的判断分数,分数范围从1到5,其中1表示轻度,5表示严重,两名医生之间的判断结果互不影响、互相独立。
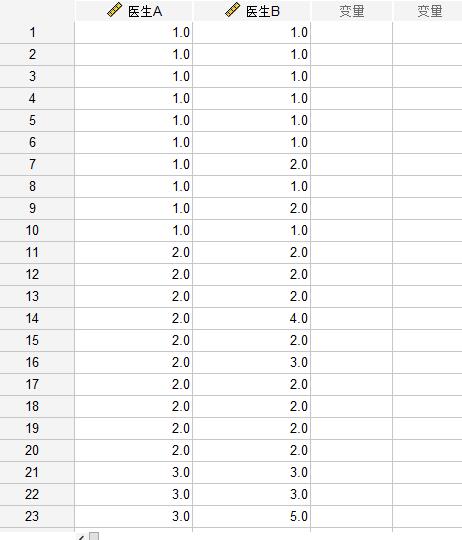
图1:演示数据展示
对于这类有序分类的变量一致性检验,我们就需要采用到加权Kappa系数进行计算分析。第一步:点击【分析】中的【描述统计】项,在右侧展开栏中选择【交叉表】。
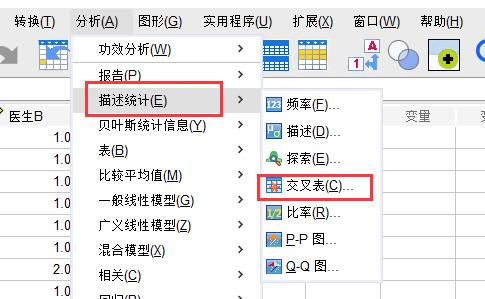
图2:交叉表
第二步:在交叉表中,我们在行中填入医生A,在列中填入医生B,然后点击“确定”,让SPSS为我们生成这2组数据的交叉表。
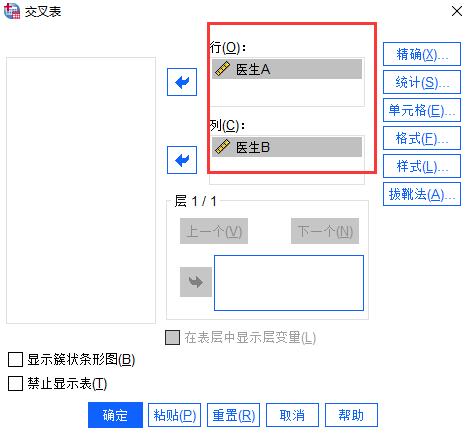
图3:交叉表填入行和列
生成的交叉表如图4所示,我们直接看图4红框标出来的位置,即对角线上的数据,这表示两位医生对于疾病严重程度的诊断还是比较一致的;当然,诊断结果也不是完全一致,因为在非对角线位置,还是有一些不为0的地方。
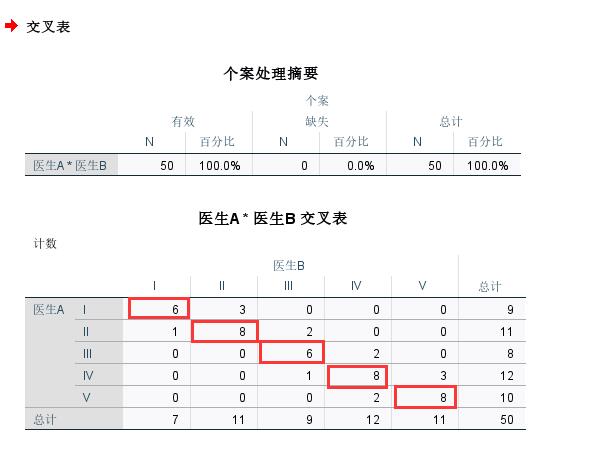
图4:交叉表结果分析
二、加权Kappa
接下来我们使用加权Kappa系统来对数据一致性进行分析,点击【分析】--【刻度】--【加权Kappa】,如图5。
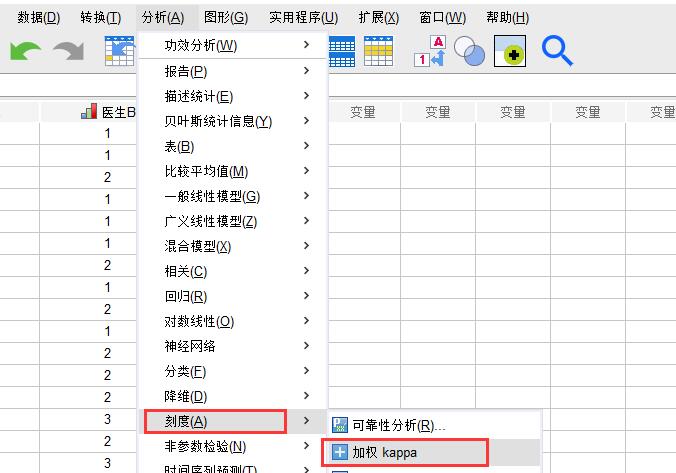
图5:加权Kappa
随后在评分1中填入医生A,在评分2中填入医生B,权重类型采用默认的线性类型即可,下方的CI覆盖水平默认为95%,意思就是获取加权Kappa系统的95%的置信区间,我们也可以按需调整为常用的99%置信区间或其他置信区间。
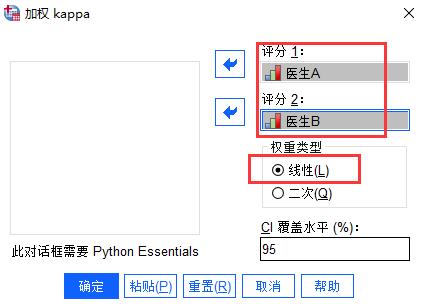
图6:加权Kappa设置
上述的权重类型,线性类型表示每个级别之间的差异是相等的,即1到2和2到3之间的差异是一致的;而二次类型,则表示1到2和2到3之间的差异是不同的,2到3之间的差异相比于1到2要更严重。因此,综上我们采用线性权重类型。
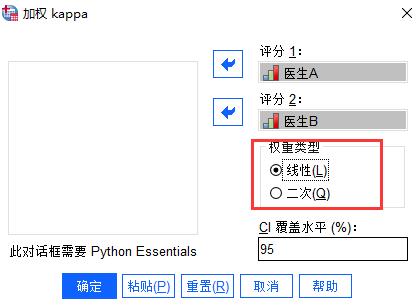
图7:权重类型
最终得出的加权Kappa结果如下图8,Kappa系数为0.822,我们认为,Kappa系数越接近1,则一致性就越强,因此本组数据两位医生之间的结果一致性是强一致性,也符合上述交叉表得到的结果。另外,从结果中我们还可以得出加权Kappa系数的95%置信区间为0.739到0.904。
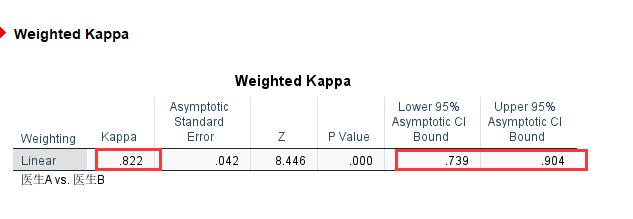
图8:结果展示
本文中采用了交叉表和加权Kappa两种不同的方法,探索两位医生对疾病严重的程度结果判断的一致性,最终都认为它们之间具有强一致性。这就是关于IBM SPSS Statistic软件使用加权Kappa插件进行一致性分析的全部教程,希望能给大家带来帮助。
作者署名:包纸
展开阅读全文
︾
读者也喜欢这些内容:
SPSS 安装激活流程
...
阅读全文 >
SPSS软件购买大概花多少钱 SPSS软件版本有什么区别
市面上的数据分析软件有很多,如SPSS、Graphpad和Stata等等,这些软件帮助我们进行许多领域的数据分析,例如临床医学中的药品效果验证、农业中的农药防治病虫害效果和社会科学的人口数据调查等等。SPSS是其中应用十分广泛的一款软件,接下来我就介绍一下SPSS软件购买大概花多少钱,SPSS软件版本有什么区别。...
阅读全文 >
什么是SPSS精确检验 SPSS Fisher精确检验和Pearson卡方检验有什么区别
在数据分析中,分类变量的关联性检验是找到数据内在规律的重要方法。SPSS作为常用到的统计软件,针对不同的数据模型,提供了Pearson卡方检验与Fisher精确检验两种不同的检验方法。下面我们将为大家介绍什么是SPSS精确检验,以及SPSS Fisher精确检验和Pearson卡方检验有什么区别的相关内容。...
阅读全文 >
SPSS数据编码如何操作 SPSS数据编码数值替换方法
数据编码,从字面上解释就是将原始的数据转化为软件代码,使软件能够更好地进行数据分析工作,而使用SPSS就能实现不同类型的数据编码程序。接下来,我就以SPSS数据编码如何操作,SPSS数据编码数值替换方法这两个问题为例,来向大家讲解一下数据编码的相关知识。...
阅读全文 >
