


 400-8765-888
 kefu@makeding.com


仅剩:

发布时间:2021-07-09 11: 38: 13
排序功能是数据统计软件必不可少的一项主要功能,当我们在进行缺失值的查找、重复值的查找以及数据排名时,排序功能就显得非常方便有用。掌握好IBM SPSS Statistics的排序功能,是熟练掌握SPSS的前提,别看只是小小的排序功能,里面的门道可真不少。
接下来我来一一为大家讲解IBM SPSS Statistic软件的排序功能。
一、单变量排序
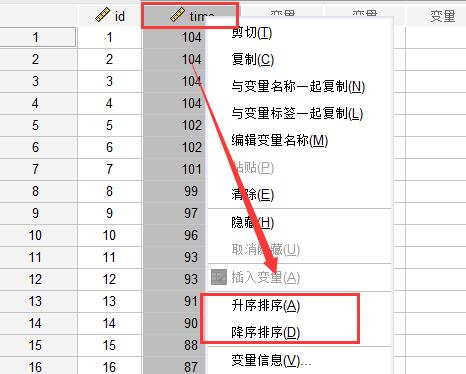
首先来讲讲单个变量的排序功能,这点和Excel的排序是非常相似的,我们点击表头,打开变量右键菜单,可以看到“升序排序”功能和“降序排序”功能,如图1,点击它们可以对变量进行单个排序。
二、个案排序
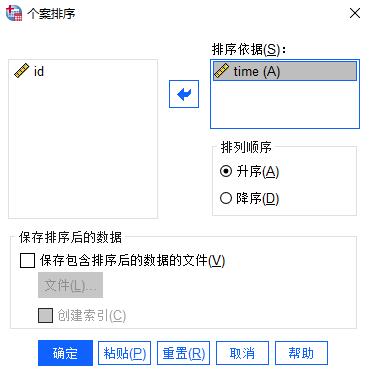
第二个排序功能是个案排序功能,它针对的主体是数据个案而不是单个变量。我们点击【数据】-【个案排序】,进入个案排序界面,然后输入排序的依据变量,选择排序顺序是升序还是降序,点击“确定”,即可对数据的个案进行排序。
三、多变量排序
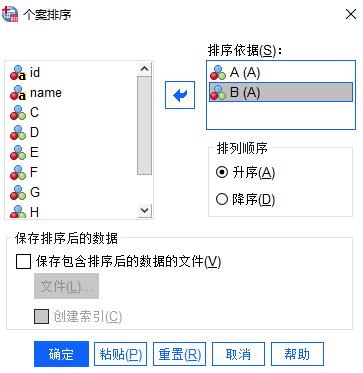
多变量排序的话,使用到的功能依旧是上图2的个案排序,只不过排序依据为多个变量。比如下图3,表示先按照A变量进行升序排序,如果A变量相同的情况下,再按照B进行升序排序,其中A变量为主要依据,B变量为次要依据。
四、个案排秩
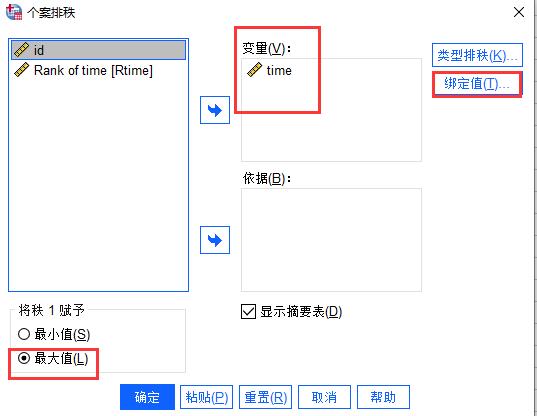
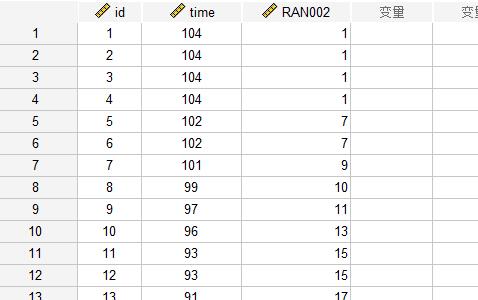
作为数据分析或展示,我们在数据排序之后如果再加上一列名次,记忆效果会更好。点击【数据】-【个案排秩】,输入排序变量,将秩1赋予最大值,然后点击“绑定值”按钮,选择分配给绑定值的秩为低。
个案排秩后的数据结果见图5,其中RAN002表示排列出来的名次,time为104的数据排名第一位;time为102的数据排名第七位。
五、条件分组排序
最后一个较为复杂的排序功能是条件分组排序功能。第一步,点击“可视分箱”,填写分箱化变量名称,随后点击“生成分割点”,输入第一个分割点位置和分割点数,如本例的80和5,点击确定,再点击生成标签,此时分箱界面见图6。
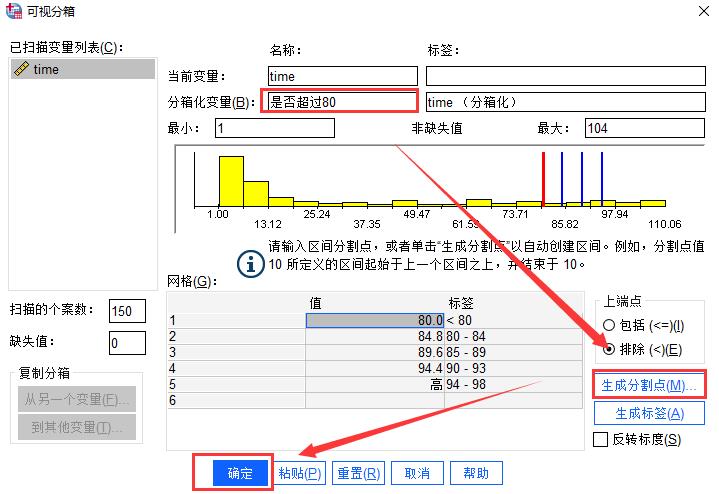
点击确定后我们就将数据按照大于等于80和小于80分成了两组,接下来选择【数据】-【拆分文件】,对数据进行分组排序。
界面如图7,我们选择“比较组”,然后设置分组依据为分箱后生成的变量,选择“按分组变量进行文件排序”,最后点击确定。
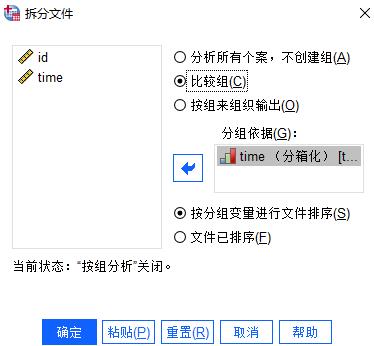
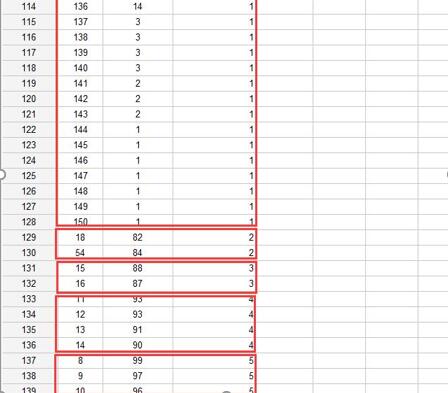
图8就是条件分组后的排序结果,其中1、2、3、4、5这五个分组都对time变量进行了降序排序。
上述就是关于IBM SPSS Statistics中提供的五种不同排序的相关功能,灵活用好这些排序功能,能帮助我们在统计分析过程中得到更直观的视图结论,同时有助于我们快速了解数据和推进数据分析过程的整体效率。
作者署名:包纸
展开阅读全文
︾
读者也喜欢这些内容:

SPSS排序题怎么编码 SPSS多选排序题怎么分析
在进行数据分析时,尤其进行商业调查中的数据分析时,我们经常会遇到排序题,例如:消费者根据自己的考虑因素,对商品的包装、品牌和价格进行排序,这样我们就会得到一组排序的数据。在SPSS中分析排序题与分析其他数据有所不同,我们会使用到“编码”功能,然后再进行分析。本文就给大家介绍一下关于SPSS排序题怎么编码,SPSS多选排序题怎么分析的相关内容。...
阅读全文 >
SPSS事后比较怎样进行 SPSS事后比较多重校正应如何设置
在数据分析的过程中,经常会在数据分析之后对它进行事后比较的操作。事后比较可以在方差分析的基础之上帮助我们快速找到具体存在差异的数据组。简单来说,大家可以把方差分析理解为起到了一个提示作用,告诉了我们数据样本中的均值并不相等且存在差异,但是如果想要找到具体的差异点在哪里,就需要用到事后比较了。而在进行事后比较的过程中,还会遇到设置多重校正的情况。下面以SPSS为例,给大家介绍SPSS事后比较怎样进行,SPSS事后比较多重校正应如何设置。...
阅读全文 >
SPSS如何导出分析报告 SPSS报表内容丢失怎么修复
数据分析报告作为承载着数据分析结果的重要内容,既起到了数据样本分析总结的作用,又可以将这部分数据分析结果应用到其他的领域和研究当中(可以作为重要的数据样本参考)。所以导出数据分析报告和修复丢失的数据就成为了数据分析中的一个重要环节,下面以SPSS为例,向大家介绍SPSS如何导出分析报告,SPSS报表内容丢失怎么修复的具体内容。...
阅读全文 >
SPSS个案排秩的优缺点 SPSS个案排秩的步骤
SPSS作为一款优秀的数据统计分析软件,可以帮助我们解决很多复杂的统计分析工作,例如SPSS中的个案排秩功能,能让我们对数据集中的某个变量数据进行大小排序,并生成新变量,可以更直观的展现变量数据。接下来给大家介绍的就是有关SPSS个案排秩的相关内容,SPSS个案排秩的优缺点,SPSS个案排秩的步骤。...
阅读全文 >
