- 首页
- 产品
- 下载
- 学生专享NEW
-
帮助中心
SPSS数据重构—将选定个案重组为变量
发布时间:2020-11-13 11: 04: 42
IBM SPSS Statistics的数据重构功能,也被称为数据重组,包含了将选定变量重组为个案、将选定个案重组为变量与变换所有数据(即数据转置)的功能。
本文中,会进行“将选定个案重组为变量”的功能讲解。当我们要进行分组变量的分析时,就需要将个案组数据转换为变量组数据,比如一般线性模型分析中的单变量、多变量和方差成分。
一、打开数据文件
首先,如图1所示,打开个案组类型的数据。当前数据展示了个案在不同页面中的浏览次数,需要将“页面编号”重组为新变量。
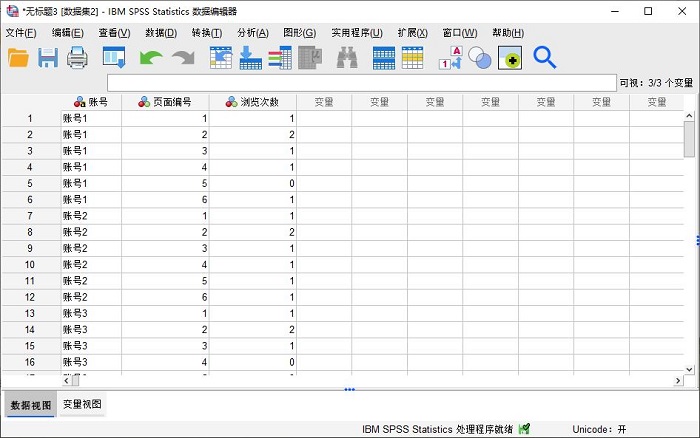
图1:打开数据文件 二、使用数据重构功能
如图2所示,打开数据菜单中的重构数据功能。
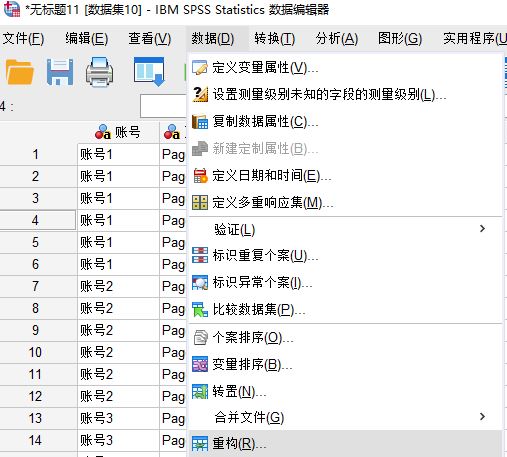
图2:数据重构功能 三、选择将个案重构为变量
如图3所示,在打开的重构数据向导中,可以选取数据重构的方法。我们选择“将选定个案重构为变量”选项。
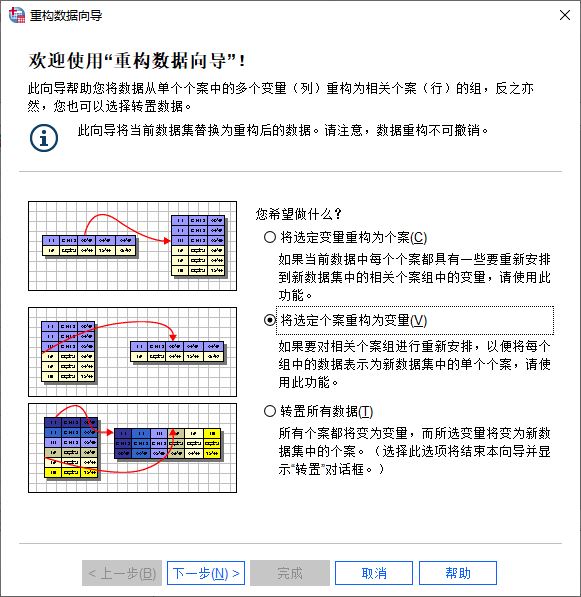
图3:重构数据向导 接着,我们需要进行比较关键的一步—选择变量。其中的变量含义如下:
1.标识变量,即用来识别个案的变量,比如本例中的“账号”变量,可用于识别个案。
2.索引变量,当前数据中用于创建新列的的变量。当变量添加为索引变量后,系统会将该变量中的变量值重组为新列变量。比如本例中的“页面编号”变量。
3.当前文件中的变量,不发生变更的变量,该变量的数据可能会因重构而改变。
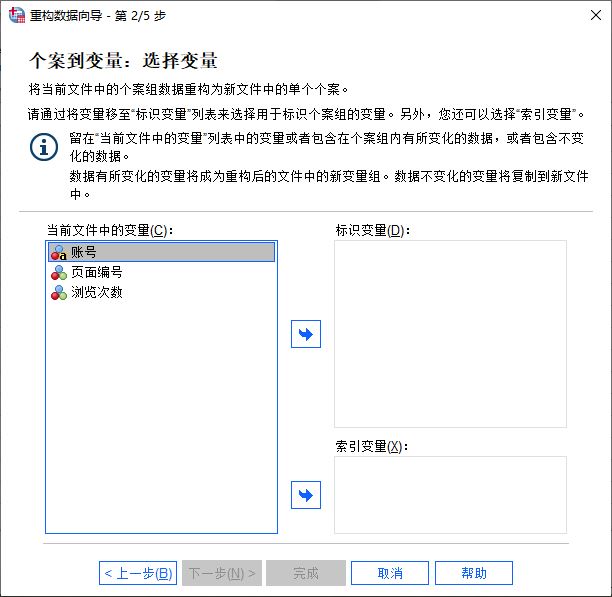
图4:选择变量 根据当前数据的重构的目的,即将“账号”的个案组数据重构为单个个案,如图5所示,需将“账号”设置为标识变量,将“页面编号”设置为索引变量,保持“浏览次数”为当前文件中的变量。
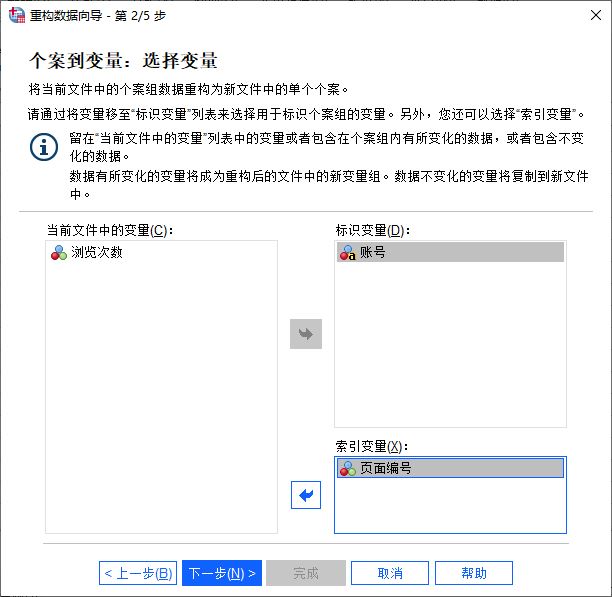
图5:设置变量 接着,设置数据的排序方式,可按照标识变量与索引变量进行排序,也可选择按照当前排序状态排序。
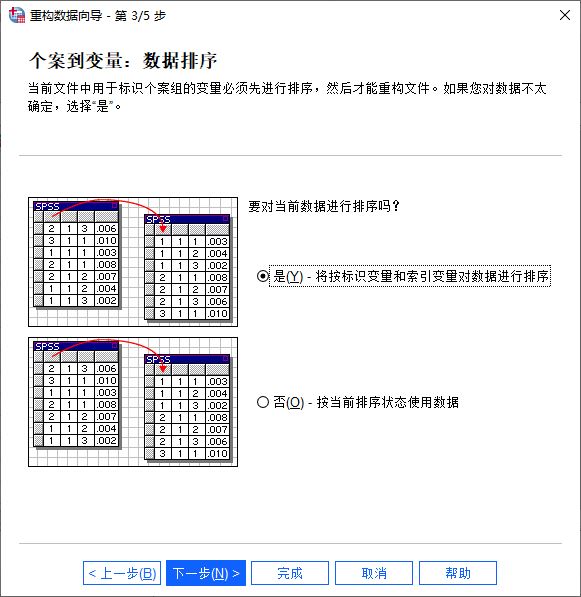
图6:排序选项 最后,对应用于重构后的数据文件选项进行设置:
1.设置新变量组的顺序,可按原始变量分组(先排序变量1,再排序变量2,如w1 w2 w3,h1 h2 h3)或按索引变量分组(所有变量放在一起排序,如w1 h1,w2 h2,)
2.添加个案计数变量
3.创建指示符变量,可使用索引变量在新的数据文件中创建指示符变量,它为索引变量的每个唯一值创建一个新变量。
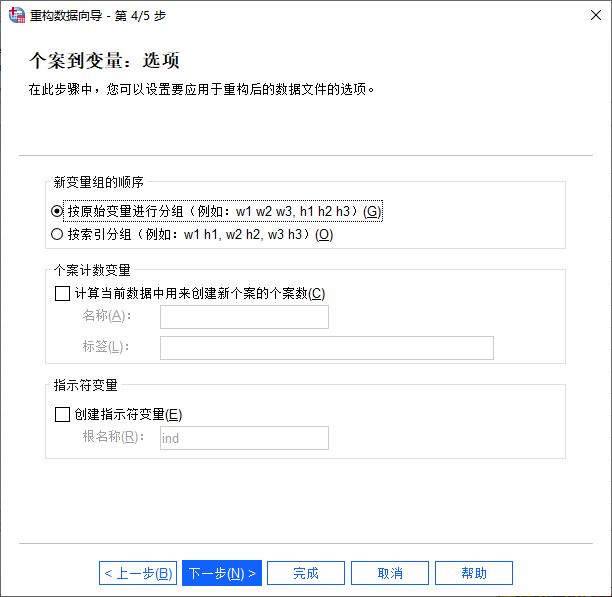
图7:重构后数据文件的选项 完成数据重构设置后,我们可以选择立即重构数据,或保存、修改算法后再重构数据。
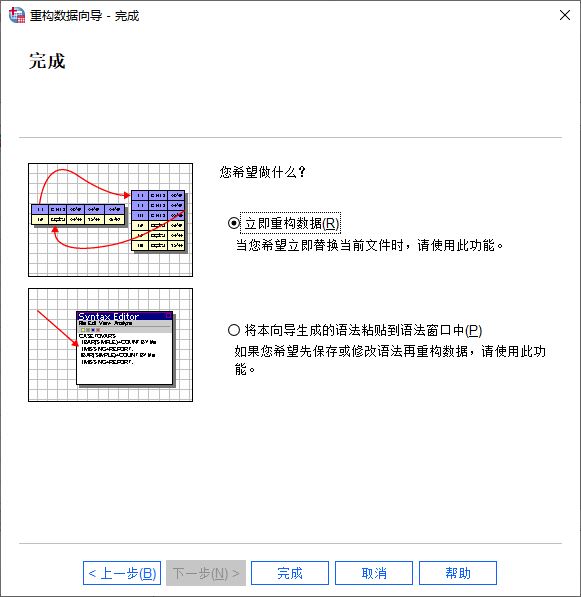
图8:保存算法或立即重构 完成数据重后,如图8所示,数据展现了在不同个案下不同索引变量的浏览次数。
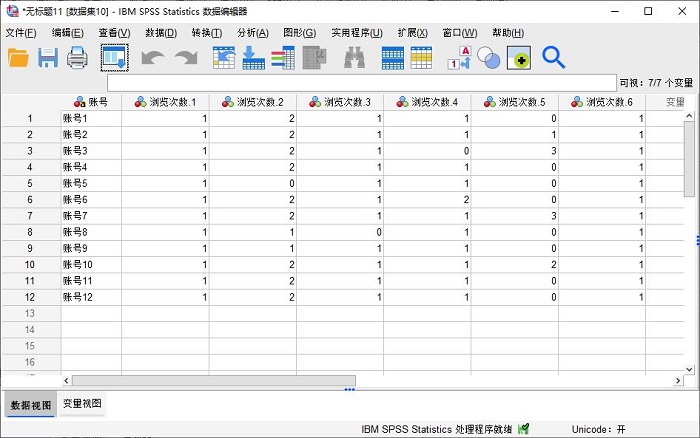
图9:完成数据的重构 以上就是SPSS数据重构中将选定个案重组为变量的方法演示,对于数据重构中的将选定变量重组为个案、数据转置的方法介绍,可前往IBM SPSS Statistics中文网继续学习。
展开阅读全文
︾
标签:SPSS数据重构,个案重组
读者也访问过这里:热门文章SPSS数据分析显著性差异分析步骤 SPSS显著性差异分析结果怎么看数据的显著性差异分析主要有三种方法,分别是卡方检验、T检验和方差分析。这三种方法都有具体的数据要求:卡方检验是对多个类别的数据进行分析,T检验是对两组数据进行分析,方差分析是对多组数据进行检验。下面,小编具体说明一下SPSS数据分析显著性差异分析步骤,SPSS显著性差异分析结果怎么看。2022-01-07实践SPSS单因素方差分析之检验结果解读在《实践SPSS单因素方差分析之变量与检验方法设置》一文中,我们已经详细地演示了IBM SPSS Statistics单因素方差分析方法的变量选择以及相关的选项、对比设置。2021-01-11spss如何做显著性分析 spss显著性差异分析怎么标abc在统计分析中,显著性分析是分析相关因素之间是否存在显著影响关系的关键性指标,通过它可以说明分析结论是否由抽样误差引起还是实际相关的,可论证分析结果的准确性。下面大家一起来看看用spss如何做显著性分析,spss显著性差异分析怎么标abc。2022-03-14SPSS回归分析中的f值是什么 SPSS回归分析F值在什么范围合适回归分析中以R表示相关性程度的高低,以F评价回归分析是否有统计学的意义,使用IBM SPSS Statistics进行回归分析,可以非常快速的完成R,F的计算,并且给出回归曲线方程,那么,SPSS回归分析中f值是什么?SPSS回归分析F值在什么范围合适,本文结合实例向大家作简单的说明。2022-07-22SPSS多元logistic回归分析的使用技巧回归分析是数据处理中较为常用的一类方法,它可以找出数据变量之间的未知关系,得到较为符合变量关系的数学表达式,以帮助用户完成数据分析。2021-04-26SPSS相关性分析结果怎么看相关性分析是对变量或个案之间相关度的测量,在SPSS中可以选择三种方法来进行相关性分析:双变量、偏相关和距离。2021-04-23最新文章30 天免费试用|IBM Bob,打通 IDE 与命令行的 AI 开发助手IBM Bob 是 IBM 推出的 AI 驱动开发伙伴,能够深入开发人员的代码库,从需求分析、代码编写、项目理解,到测试、调试和应用现代化,全流程辅助软件开发工作,帮助团队更快速地构建高质量软件。2026-09-16SPSS怎样进行效度检验 SPSS效度结果不理想怎么办我们做数据分析时,大多都需要开展效度分析。效度分析是数据统计中一个重要的概念,它用于衡量问卷数据的准确有效性。而我们在进行效度分析时,一款好用的数据分析软件可以提高我们的工作效率,这里给大家介绍一款我自己常用的数据分析软件—SPSS,同时将以SPSS为例,介绍SPSS怎样进行效度检验,SPSS效度结果不理想怎么办的具体内容。2026-09-04什么是验证性因子分析 验证性因子分析可以用SPSS做吗在数据分析的领域当中,因子分析是数据分析中重要分析方法,它在不同的研究领域中都有着广泛的应用。例如在心理学分析的过程中,如果需要分析一个人的睡眠质量问题,那么就需要设置不同的观测因子。依托观测因子可全面收集受试者信息,推导睡眠质量评价结果。而验证因子分析就可以进一步核实这部分数据,进而验证分析的合理性。下面以SPSS为例,给大家介绍什么是验证性因子分析,验证性因子分析可以用SPSS做吗。2026-09-02SPSS个案百分比怎么操作 SPSS个案百分比和响应百分比一样吗个案百分比,是一种以样本数(总人数)作为分母的统计量,可以用来看样本群体里选择某个选项的比例。个案百分比与平常用的百分比不同,后者计算的是某个选项在所有答案中的占比,两者的区别在于分母不同。在SPSS软件里,我们可以轻松计算出各种百分比的数值。接下来我们会介绍SPSS个案百分比怎么操作,SPSS个案百分比和响应百分比一样吗的相关内容,让大家可以更熟悉这方面的内容。2026-09-02SPSS个案数与实际不相符怎么办 SPSS个案数不足两个怎么办个案数,在数据统计分析里面一般指的是所研究问题的样本数量。在数据处理阶段,一般会先检查个案数与实际采集的样本数量是否相符。如果不相符的话,需要检查数据,并找到不相符的原因。在SPSS软件里,可以用描述分析、缺失值分析、重复值识别等方法帮助检查数据的问题。接下来,我们会介绍SPSS个案数与实际不相符怎么办,SPSS个案数不足两个怎么办的相关内容。2026-09-02SPSS个案排序和个案排秩的区别 SPSS个案排秩怎么操作我们在使用SPSS进行数据整理与统计分析时,个案排序和个案排秩是两种十分常用的整理方式,但很多使用者容易将二者混淆。接下来我将为大家介绍:SPSS个案排序和个案排秩的区别,SPSS个案排秩怎么操作的相关内容。2026-09-02读者也喜欢这些内容:
-
SPSS对应分析如何绘图 SPSS对应分析点位解释应怎样陈述
我们在进行数据分析的过程中,经常会遇到绘制数据分析图的情况。绘制数据分析图是将数据的分析结果可视化的重要步骤,能将繁杂的数据结果转化为直观图表。而在数据点位分析的过程中,同样也会遇到部分点位与实际结果不匹配的状况,所以我们需要对这些出现的点位对应问题进行文字陈述与分析。下面以SPSS为例,给大家介绍SPSS对应分析如何绘图,SPSS对应分析点位解释应怎样陈述。...
阅读全文 >
-

SPSS如何将数据转换成二分类 SPSS如何将数据转换成文本
原始数据类型往往无法直接满足全部分析与展示需求,所以在数据分析的过程中,我们需要将连续变量或多分类变量转换成二分类变量。而将数值编码转换成文本标签,能让数据结果更直观易懂。接下来我将为大家介绍:SPSS如何将数据转换成二分类,SPSS如何将数据转换成文本的相关内容。...
阅读全文 >
-
SPSS交叉表卡方与非参数卡方检验有何区别 SPSS交叉表卡方检验结果解读
在SPSS统计分析中,卡方检验是一种我们经常使用到的非参数方法。但是,其实很多人会混淆“交叉表卡方检验”和“非参数卡方检验”。两者虽然名字十分相似,但是针对的是完全不同的分析场景。接下来我将为大家介绍:SPSS交叉表卡方与非参数卡方检验有何区别,SPSS交叉表卡方检验结果解读的相关内容,帮助大家精准区分方法、读懂检验结果。...
阅读全文 >
-
SPSS软件安装与注册试用教程
IBM SPSS Statistics作为一款全球知名的数据统计分析软件,无论是在学术研究领域,还是商业经营领域,都起着举足轻重的作用。其推出的一系列统计分析方法,可用于数据的分析运算、挖掘、模型预测等多个方面。...
阅读全文 >
-

 400-8765-888
 kefu@makeding.com