


 400-8765-888
 kefu@makeding.com


仅剩:

发布时间:2020-11-12 13: 57: 37
IBM SPSS Statistics的数据重构功能,也被称为数据重组,包含了将选定变量重组为个案、将选定个案重组为变量与变换所有数据(即数据转置)的功能。
为什么要进行数据重组?这是因为一些分析方法可能需要采用个案组或变量组的数据来分析,因此,需要通过重组的方式转换数据。本文将会重点介绍如何将选定变量重组为个案。
一、打开数据文件
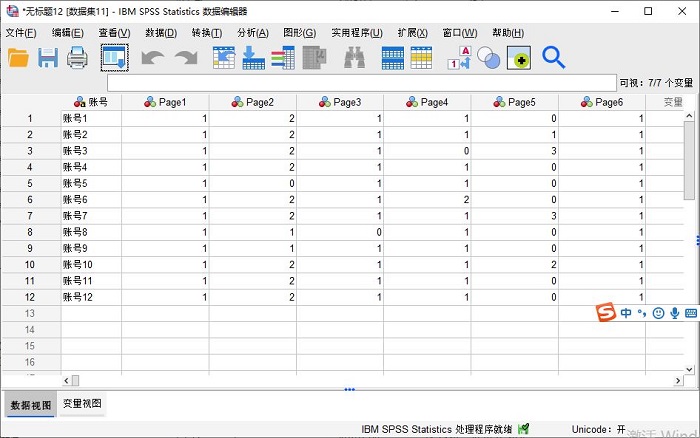
首先,如图1所示,打开变量组类型的数据。该数据记录了每个账号在不同页面的浏览次数。
二、使用数据重构功能
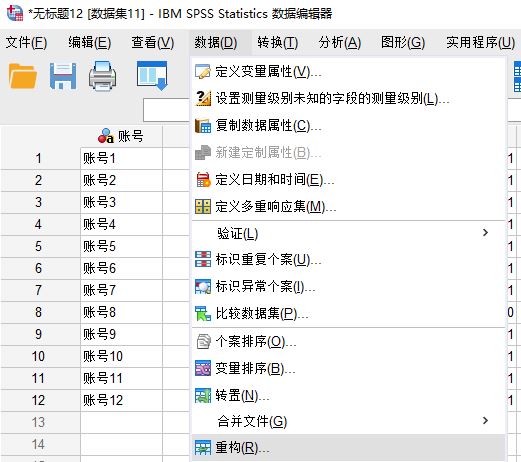
接着,如图2所示,打开数据菜单中的重构选项。
三、选择将选定变量重构为个案
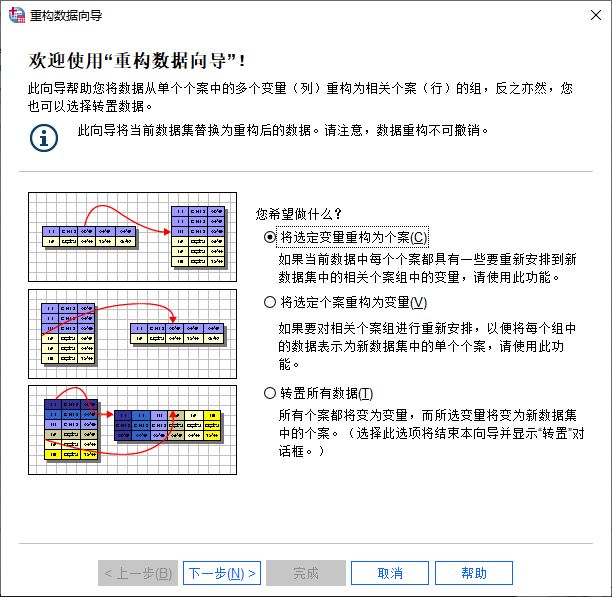
如图3所示,在打开的重构数据向导中,可以选取数据重构的方法。我们选择“将选定变量重构为个案”选项。
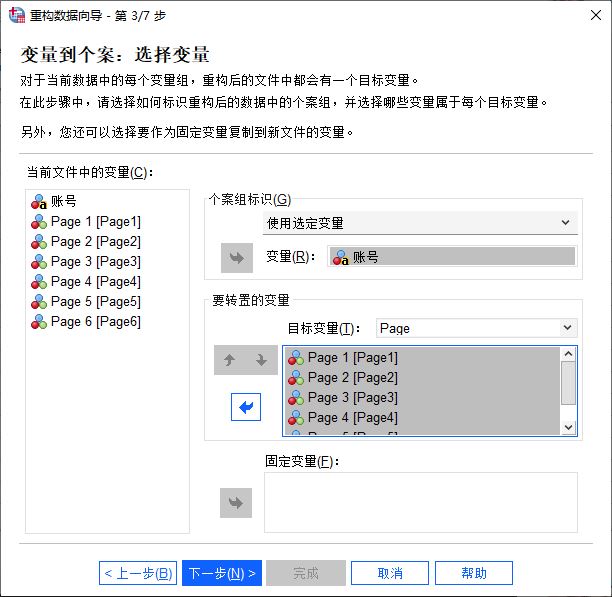
接着,就会来到比较关键的步骤-选择变量。我们来看看如何进行变量选择:
1.当前文件中的变量,即当前数据集中所包含的变量。
2.个案组标识,即用以识别个案的变量,比如本例中的“账号”变量,可作为个案组标识来识别不同的个案。
3.目标变量,即重构后出现的变量,需要将需重构的变量添加为“要转置的变量”,然后再为这些转置的变量创建一个目标变量,说明这些转置变量的特征。比如在本例中,将“Page1-6”的变量添加为要转置的变量,然后创建一个名为“Page”的目标变量。
4.固定变量,即保持不变的变量,本例中无固定变量。
如图4所示,我们已经按照变量的属性完成了变量的选择。
接着,需要创建索引变量。
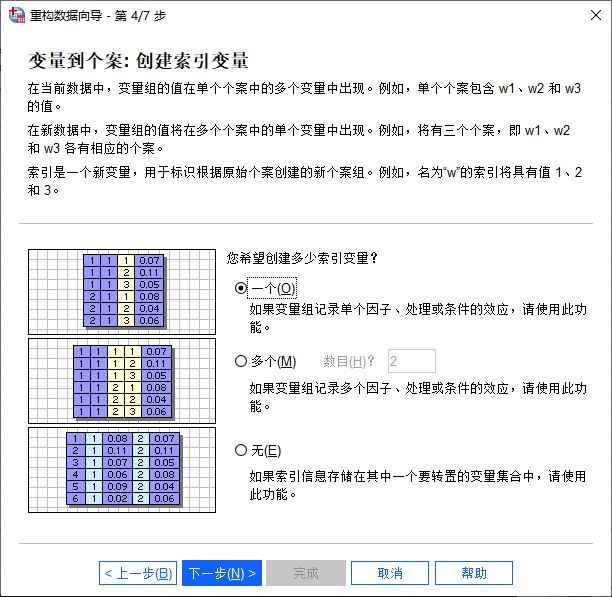
当创建的目标变量的数值在单个个案中会有多个变量出现时,就需要创建索引变量识别。本例中,我们使用的是单因子的目标变量,可以选择创建“一个”索引变量。
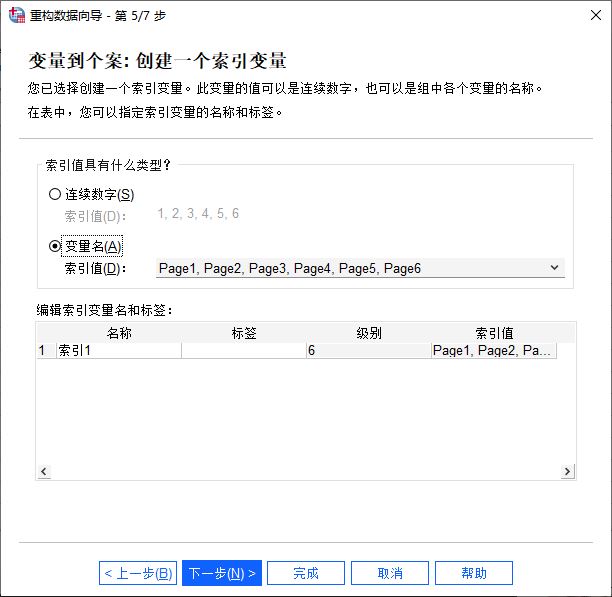
然后,再设置索引值的类型,方便识别不同个案目标变量对应索引值的含义。如图6所示,可使用连续数字或变量名进行识别。
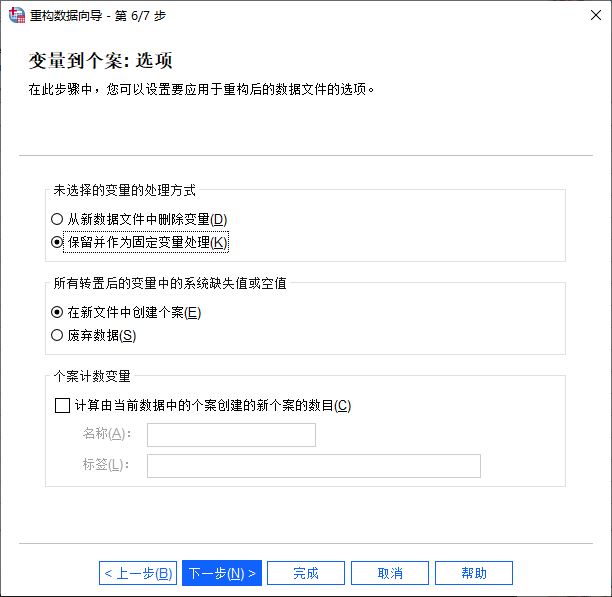
最后,对应用于重构的数据文件选项进行设置:
1. 对未选择的变量的处理方式,删除或保留为固定变量
2. 转置后的变量中的系统缺失值或控制,创建新个案或废弃数据
3. 创建计数变量
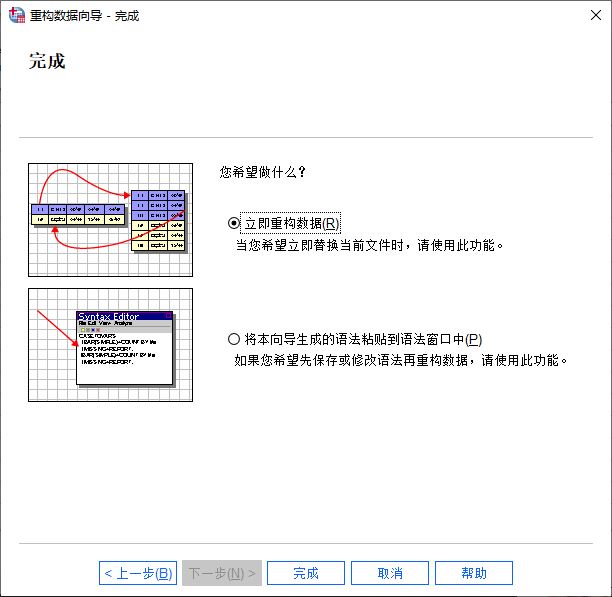
完成数据重构设置后,我们可以选择立即重构数据,或保存、修改算法后再重构数据。
完成数据重构后,可以看到账号1中包含了6种索引值变量,对应每一个索引值变量,有其对应的“Page”数。
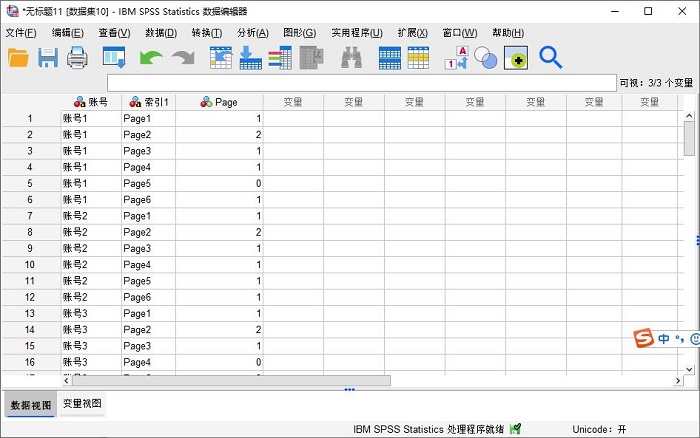
以上就是SPSS数据重构中将选定变量重组为个案的方法演示,对于数据重构中的将选定个案重组为变量、数据转置的方法介绍,可前往IBM SPSS Statistics中文网继续学习。
展开阅读全文
︾
读者也喜欢这些内容:

SPSS如何将数据转换成二分类 SPSS如何将数据转换成文本
原始数据类型往往无法直接满足全部分析与展示需求,所以在数据分析的过程中,我们需要将连续变量或多分类变量转换成二分类变量。而将数值编码转换成文本标签,能让数据结果更直观易懂。接下来我将为大家介绍:SPSS如何将数据转换成二分类,SPSS如何将数据转换成文本的相关内容。...
阅读全文 >
SPSS因子分析选择变量是什么 SPSS因子分析综合得分怎么计算
我们在进行多变量数据分析的过程中,因子分析是其中一种经典的降维技术。下面我将举一个评价学生能力的实际案例,选取课堂表现(X1)、作业完成(X2)、理论考试(X3)、实践操作(X4)、创新能力(X5)、团队协作(X6)6个变量为研究对象,进行因子分析操作。接下来我将为大家介绍:SPSS因子分析选择变量是什么,SPSS因子分析综合得分怎么计算的相关内容。...
阅读全文 >
SPSS如何导入日期数据 SPSS导入日期数据后格式不对怎么调整
通过对不同时态下物体的发展状态进行分析,我们可以获得一条明确的发展脉络图,借由这份脉络图,我们可以预测事物未来的发展趋势。今天我就以SPSS如何导入日期数据,SPSS导入日期数据后格式不对怎么调整这两个问题为例,来向大家讲解一下SPSS中关于日期数据的知识。...
阅读全文 >
SPSS如何做因子分析 SPSS因子载荷解释不清晰怎么办
每当我们在进行数据分析的工作时,因子分析是绕不开的一个话题。它在一组数据的分析中占据了重要的位置,主要用来检验不同变量之间是否存在共性的因子,而这些因子会影响数据的变量,例如从学生的考试成绩中判断是否存在共有的数据因子,这部分共有的数据因子对学生的成绩好坏会产生影响。下面我们以一款专业的数据分析软件SPSS为例,向大家介绍SPSS如何做因子分析,SPSS因子载荷解释不清晰怎么办的具体内容。...
阅读全文 >
