- 首页
- 产品
- 下载
- 学生专享NEW
-
帮助中心
如何在SPSS中进行数据的纵向和横向合并
发布时间:2021-05-06 10: 55: 01
众所周知要对数据进行分析,首先要做的是对数据进行收集。这就造成了数据的来源往往是多方面的,我们必须要把数据合并到一个文件中才能进行分析,本文我将在IBM SPSS Statistics中教大家两种数据合并方式:数据的纵向合并和数据的横向合并。
一、数据的纵向合并
官方对于数据纵向合并的定义是:几个数据集中的数据纵向相加,形成一个新的数据集。这里我举一个通俗的例子来说明,假设班里有七个同学,数据集中有这几个同学的信息,现在又来了几个同学我们需要把这几个同学的信息加到原先的数据集中,这个过程就叫做数据的纵向合并。
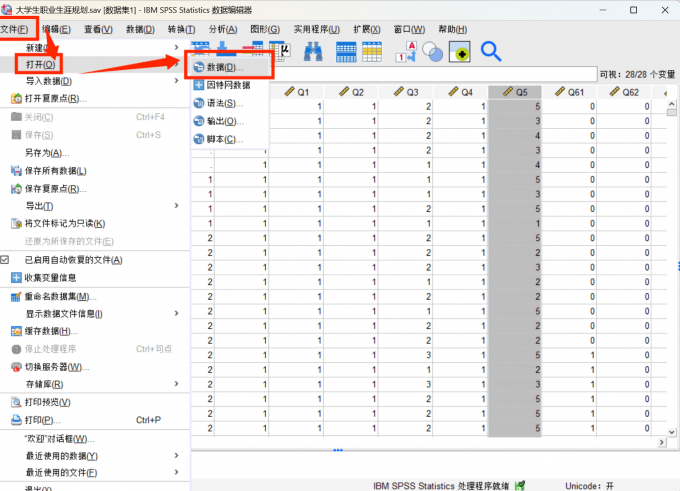
1、打开数据
进入打开数据窗口,选择需要合并的原始数据进行打开。
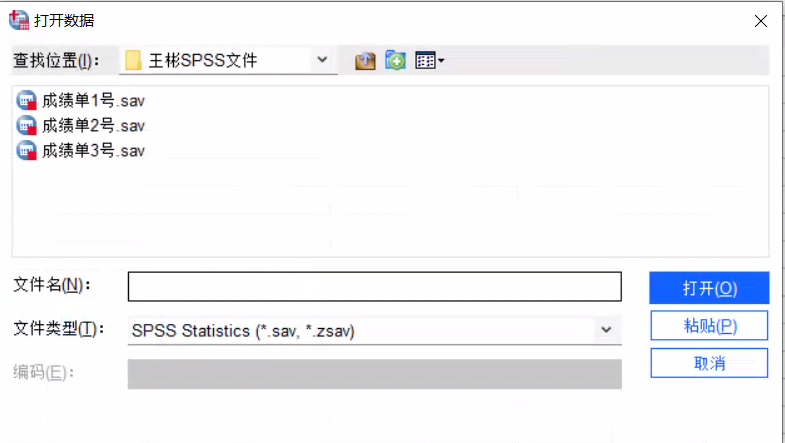
图片1:打开数据 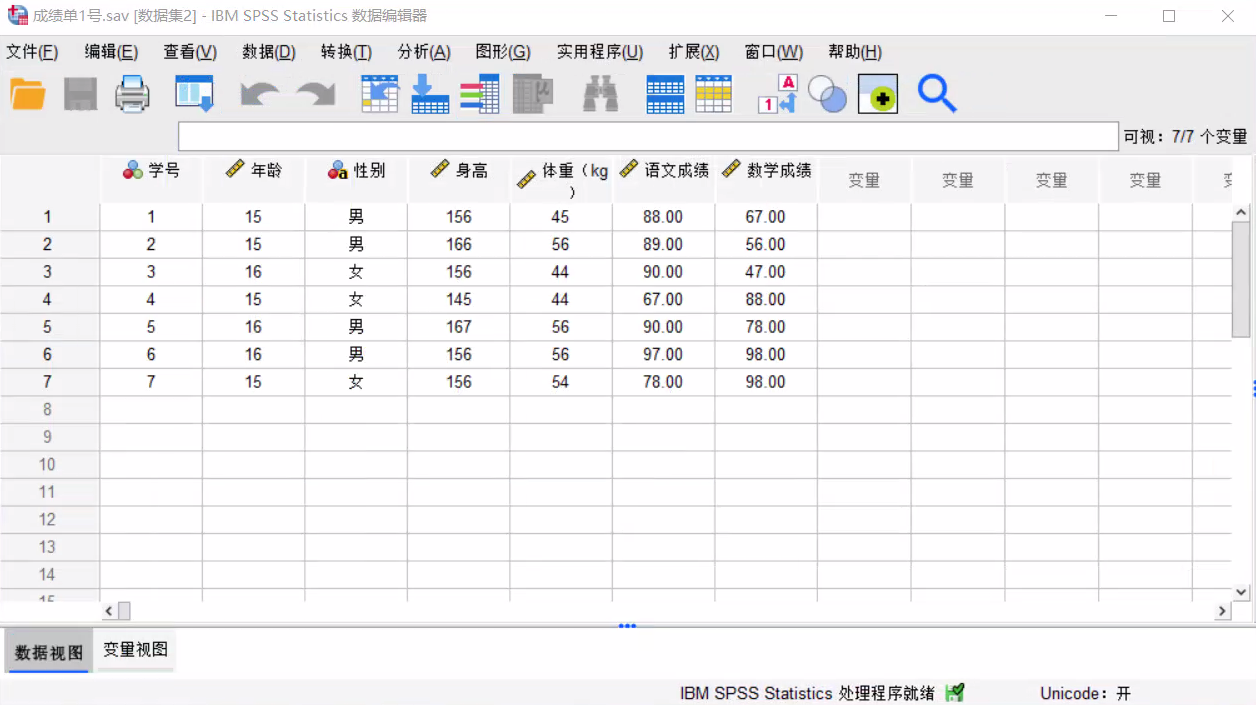
图2:打开数据展示 2、选择需要添加的个案
如图3所示第一步我们点击菜单栏中的“数据”选项,第二步点击下级菜单中的“合并文件”,第三步选择“添加个案”。
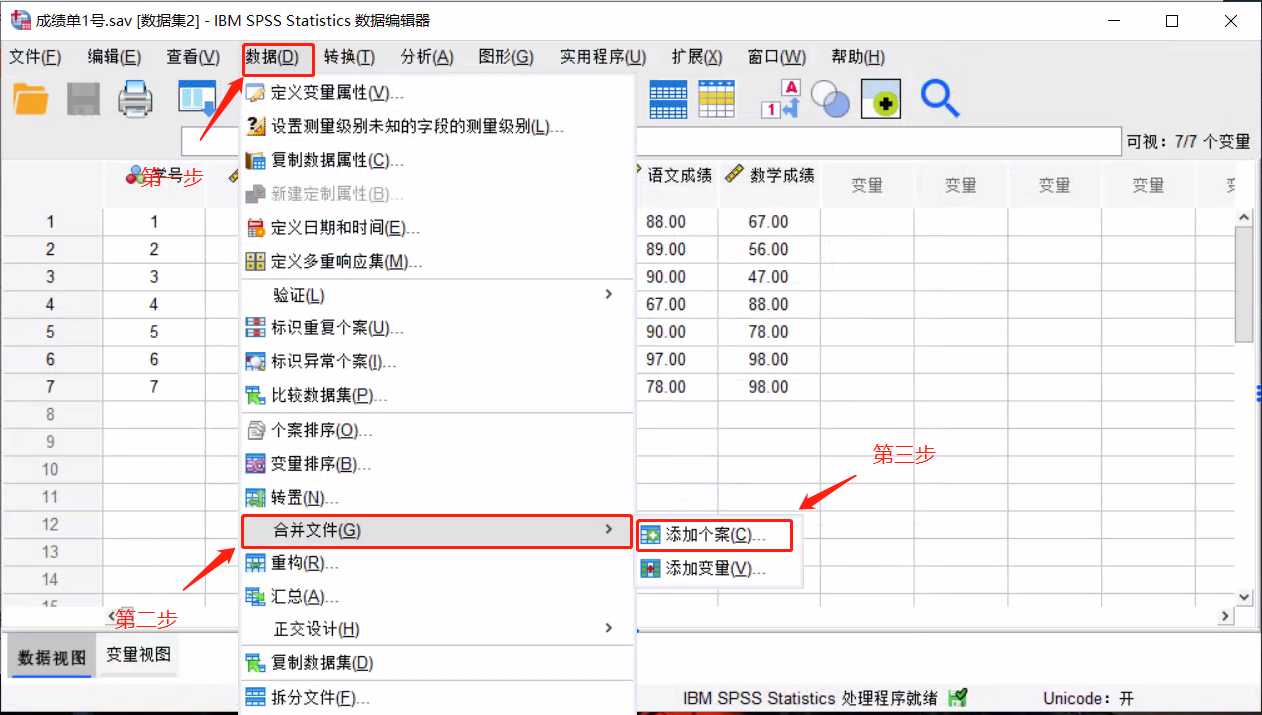
图3:具体操作 3、浏览添加的个案
进入添加个案窗口后,我们点击“浏览”按钮选择具体需要添加的文件路径名,然后点击“继续”按钮。
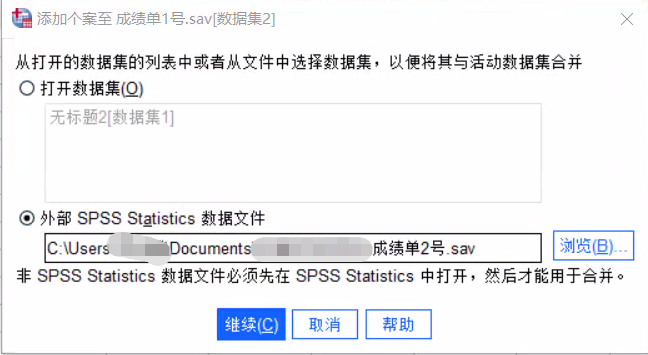
图4:浏览路径 4、对添加个案的编辑
这一步有两点需要说明,第一是非成对变量的含义,非成对变量的意思是我们在合并两个数据集的时候,可能出现两个变量的名称、含义、规格等不相同的情况。指示个案源变量的含义是,用0和1来标记数据的来源,0代表我们原先的数据,1代表添加个案中的数据。
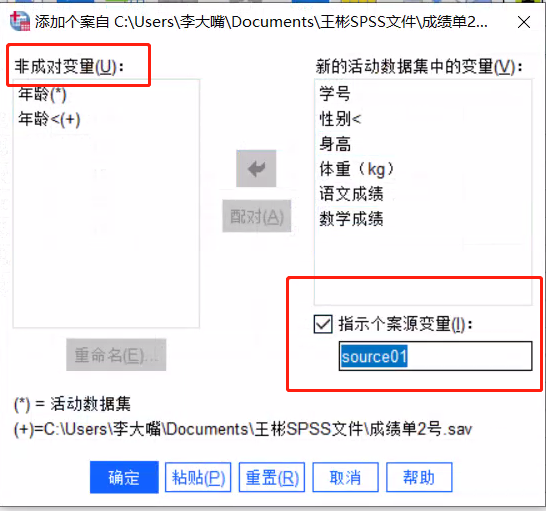
图5:个案编辑窗口 5、最后结果展示
如图6所示,我们已经在原先的数据中成功添加了新的数据。
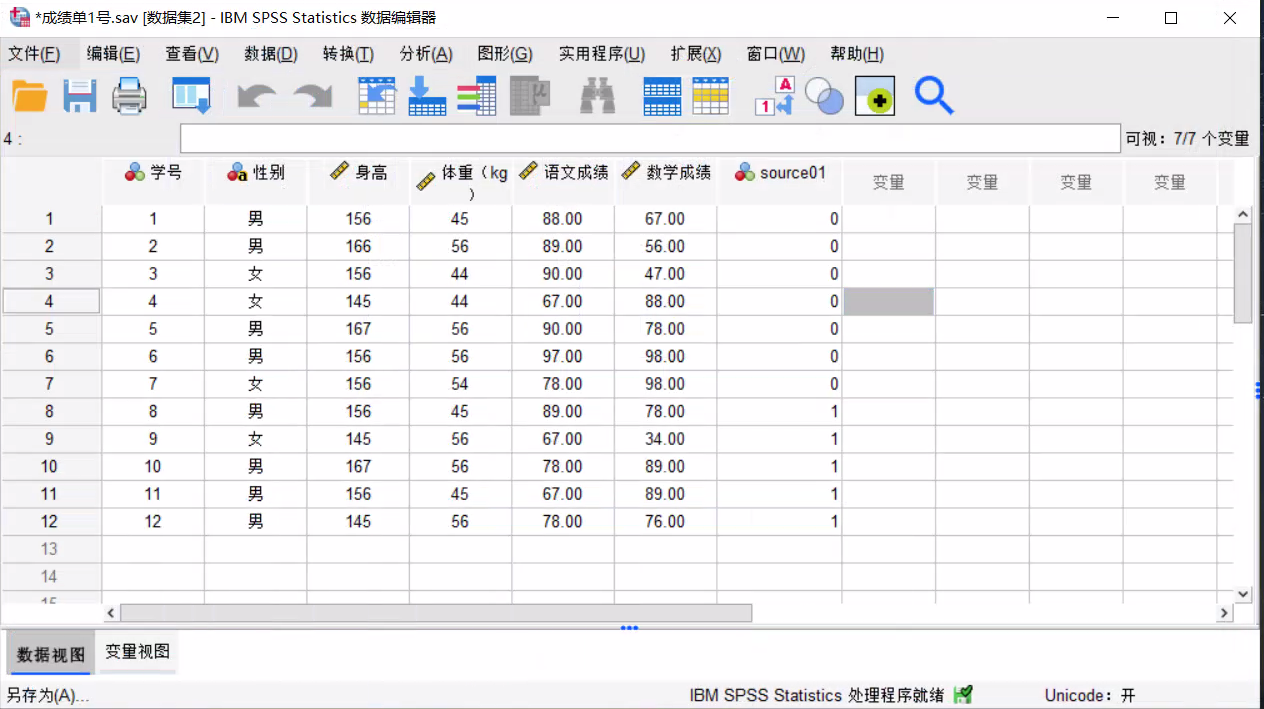
图6:最后结果展示 二、数据的横向合并
官方对于数据的横向合并的定义是按照记录的次序或者某个关键变量的数值,将不同数据集中的不同变量合并作为一个数据集,新的数据中的变量数是所有原数据集中不重名的变量的总和。举一个通俗的例子,有一个数据集中存储的学生的信息和语文成绩,另一个数据集中存储着学生的信息和英语成绩,现在我们想要把英文成绩和语文成绩都合并到一个数据集中这个过程就叫做横向合并。
1、添加变量
打开数据和上文纵向合并一样,所以直接展示添加变量操作。如图所示,第一步点击菜单栏中的“数据”按钮,第二步点击下级菜单中的“合并文件”按钮,第三步选择“添加变量”。
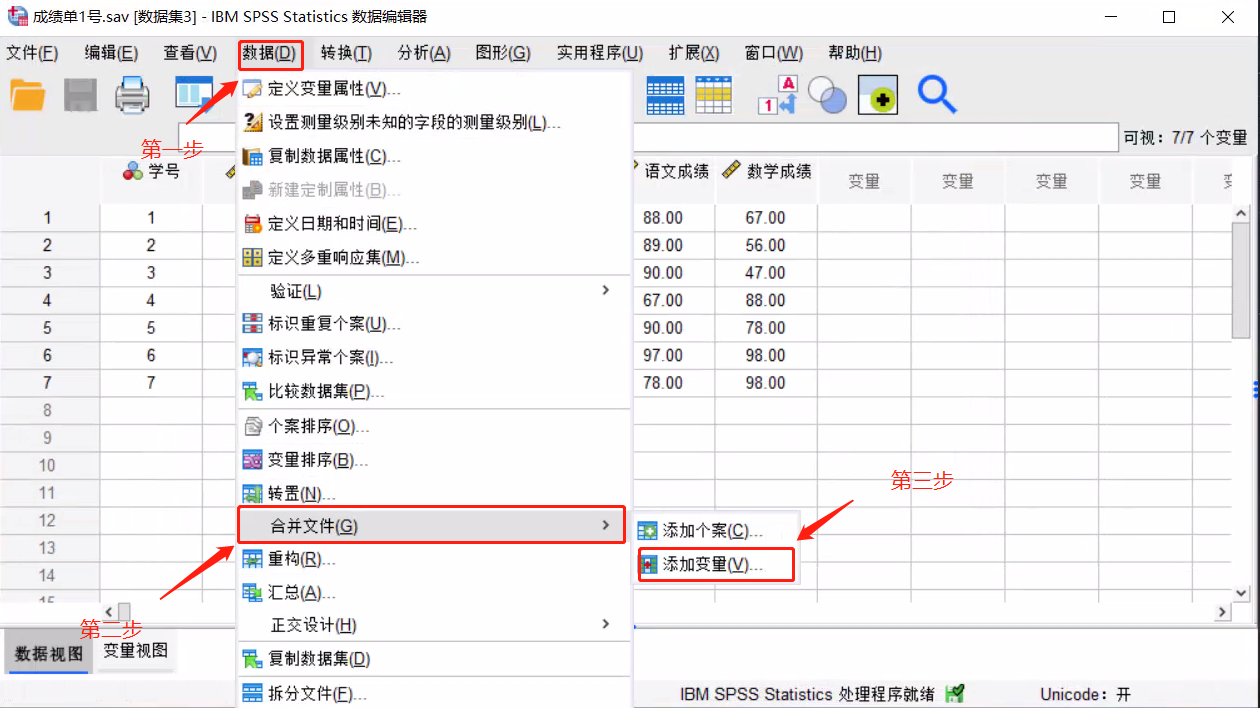
图7:添加变量 2、选择键变量
键变量是链接两个数据集的关键,通俗讲就是两个数据集中相同的变量名称。比如两个数据集中都有一个叫做学号的变量,那学号就可以作为键变量。
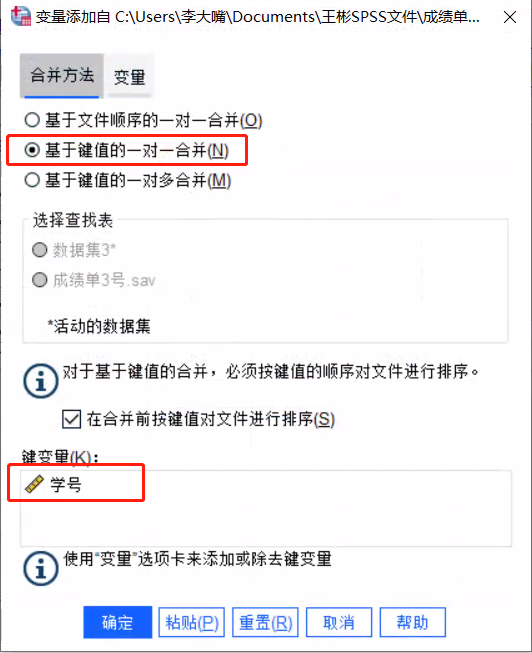
图8:键变量 3、结果展示
如图所示,原本不存在的英语成绩被合并到了这个数据集中。
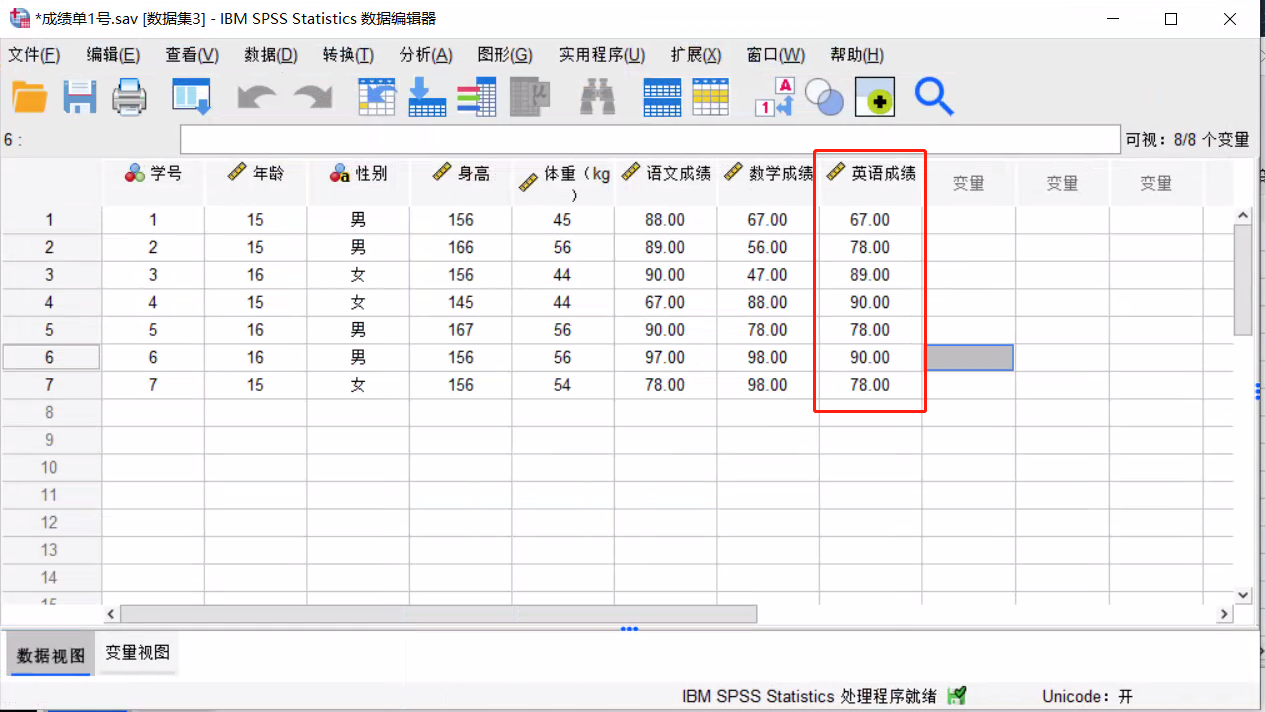
图9:结果展示 本文为大家介绍了两种合并数据的方法,大家如果在数据收集之后遇到需要合并的情况,自己根据情况去选择使用。另外中文网还为大家介绍了其他知识,可以自行去浏览学习。
作者:何必当真
展开阅读全文
︾
标签:spss
- 上一篇:SPSS探索性分析教学
- 下一篇:如何用SPSS按条件选择数据
热门文章SPSS数据分析显著性差异分析步骤 SPSS显著性差异分析结果怎么看数据的显著性差异分析主要有三种方法,分别是卡方检验、T检验和方差分析。这三种方法都有具体的数据要求:卡方检验是对多个类别的数据进行分析,T检验是对两组数据进行分析,方差分析是对多组数据进行检验。下面,小编具体说明一下SPSS数据分析显著性差异分析步骤,SPSS显著性差异分析结果怎么看。2022-01-07实践SPSS单因素方差分析之检验结果解读在《实践SPSS单因素方差分析之变量与检验方法设置》一文中,我们已经详细地演示了IBM SPSS Statistics单因素方差分析方法的变量选择以及相关的选项、对比设置。2021-01-11spss如何做显著性分析 spss显著性差异分析怎么标abc在统计分析中,显著性分析是分析相关因素之间是否存在显著影响关系的关键性指标,通过它可以说明分析结论是否由抽样误差引起还是实际相关的,可论证分析结果的准确性。下面大家一起来看看用spss如何做显著性分析,spss显著性差异分析怎么标abc。2022-03-14SPSS回归分析中的f值是什么 SPSS回归分析F值在什么范围合适回归分析中以R表示相关性程度的高低,以F评价回归分析是否有统计学的意义,使用IBM SPSS Statistics进行回归分析,可以非常快速的完成R,F的计算,并且给出回归曲线方程,那么,SPSS回归分析中f值是什么?SPSS回归分析F值在什么范围合适,本文结合实例向大家作简单的说明。2022-07-22SPSS多元logistic回归分析的使用技巧回归分析是数据处理中较为常用的一类方法,它可以找出数据变量之间的未知关系,得到较为符合变量关系的数学表达式,以帮助用户完成数据分析。2021-04-26SPSS相关性分析结果怎么看相关性分析是对变量或个案之间相关度的测量,在SPSS中可以选择三种方法来进行相关性分析:双变量、偏相关和距离。2021-04-23最新文章30 天免费试用|IBM Bob,打通 IDE 与命令行的 AI 开发助手IBM Bob 是 IBM 推出的 AI 驱动开发伙伴,能够深入开发人员的代码库,从需求分析、代码编写、项目理解,到测试、调试和应用现代化,全流程辅助软件开发工作,帮助团队更快速地构建高质量软件。2026-09-16SPSS个案处理摘要是什么意思 SPSS个案组摘要和各个变量摘要的区别在正式分析数据前,我们可能要对数据的整体情况做一个简单的摸底,比如了解整体的个案数量、是否有缺失值、有效个案数量、均值、标准差等。这些事先的数据摸底,可以让我们更了解数据的分布情况,并对此选择更准确的分析方法。接下来,本文会给大家介绍SPSS个案处理摘要是什么意思,SPSS个案组摘要和各个变量摘要的区别的相关内容。2026-09-04SPSS因子载荷矩阵怎么做 SPSS因子载荷系数怎么看因子载荷矩阵是因子分析中得到的标准化相关系数,可以用来衡量变量与公共因子之间关系的矩阵,它的值越大,说明这个变量与公因子的关系越密切。因子载荷矩阵常会用在降维分析中,因为它可以看出哪些变量需要保留、哪些变量需要移除,这样就能降低数据研究的难度,SPSS可以轻松做好这类分析。接下来我们会介绍SPSS因子载荷矩阵怎么做,SPSS因子载荷系数怎么看的相关内容。2026-09-04SPSS怎么检查极端值是否正确 SPSS多因素Cox回归分析步骤我们在进行数据分析的时候,经常会遇到处理极端值和进行Cox回归分析的情况。多因素Cox回归是先完成数据筛选,再开展回归分析的统计方法,这样可以提高数据样本的精准度,避免被极端的数据影响结果。给大家举一个例子,在医学领域中,如果我们需要统一患者的平均用药值,而统计的数据结果由于误触而多输入了一位数字,导致数值扩大了十倍。这时候再依照错误的结果给患者开药,显然会出现问题,所以就需要先对数据样本进行核查后再进行分析。下面以SPSS为例,给大家介绍SPSS怎么检查极端值是否正确,SPSS多因素Cox回归分析步骤。2026-09-04SPSS怎样进行效度检验 SPSS效度结果不理想怎么办我们做数据分析时,大多都需要开展效度分析。效度分析是数据统计中一个重要的概念,它用于衡量问卷数据的准确有效性。而我们在进行效度分析时,一款好用的数据分析软件可以提高我们的工作效率,这里给大家介绍一款我自己常用的数据分析软件—SPSS,同时将以SPSS为例,介绍SPSS怎样进行效度检验,SPSS效度结果不理想怎么办的具体内容。2026-09-04什么是验证性因子分析 验证性因子分析可以用SPSS做吗在数据分析的领域当中,因子分析是数据分析中重要分析方法,它在不同的研究领域中都有着广泛的应用。例如在心理学分析的过程中,如果需要分析一个人的睡眠质量问题,那么就需要设置不同的观测因子。依托观测因子可全面收集受试者信息,推导睡眠质量评价结果。而验证因子分析就可以进一步核实这部分数据,进而验证分析的合理性。下面以SPSS为例,给大家介绍什么是验证性因子分析,验证性因子分析可以用SPSS做吗。2026-09-02读者也喜欢这些内容:
-
SPSS ROC阈值怎样确定 SPSS ROC阈值选择导致敏感度过低怎么办
说到阈值分析,我们脑海中可能会想到常规的寻找阈值关键临界点的分析方式(例如在医学当中会通过阈值分析的方式来确定药物在病人体内生效的时间临界点)。但是在有些分析场景中,就需要用到ROC曲线作为阈值分析的工具,ROC曲线作为阈值分析中的一个重要工具,可以用来找到数据点位发生明显截断变化的临界点。下面以SPSS为例,给大家介绍SPSS ROC阈值怎样确定,SPSS ROC阈值选择导致敏感度过低怎么办。...
阅读全文 >
-
SPSS显著性小于0.001的意义 SPSS显著性大于0.05怎么办
在使用SPSS软件进行数据分析工作的过程中,得到的显著性水平分析结果具有极为重要的作用。它能够帮助我们衡量变量之间是否存在真实的关联,或者不同组别数据之间是否存在实质性的差异。今天我们就一起来探讨关于SPSS显著性小于0.001的意义,SPSS显著性大于0.05怎么办的问题。...
阅读全文 >
-
SPSS如何导入Excel数据 SPSS数据变量类型设置方法
Excel虽然也可以进行数据分析,但是在论文、科研、医学等领域,用SPSS会更有效率。例如我们需要做问卷分析、回归建模、显著性检验等科研统计,可以使用SPSS,功能会更专业。在功能的侧重方面,Excel适合数据整理与基础分析;而SPSS更适合科研统计。接下来给大家介绍SPSS如何导入Excel数据,SPSS数据变量类型设置方法的具体内容。...
阅读全文 >
-
SPSS数据排序如何设置 SPSS数据排序功能最大值和最小值
数据分析作为SPSS的重要主题,包含了数量计算、数据预测、数值对比等方面,在汇总统计各类数值的基础上,我们常常会需要对数据进行排序比较,而排序就是根据数值的大小来进行排列。本文以SPSS数据排序如何设置,SPSS数据排序功能最大值和最小值这两个问题为例,带大家了解一下SPSS数据排序的知识。...
阅读全文 >

 400-8765-888
 kefu@makeding.com