- 首页
- 产品
- 下载
- 学生专享NEW
-
帮助中心
SPSS数据预处理如何排序与分列
发布时间:2021-10-28 11: 41: 30
在正式分析数据前,我们可能需要对导入IBM SPSSS tatistic中的数据作一些预处理,比如数据排序、缺失值处理、变量编码、拆分变量值等,以符合不同分析方法的数据要求。本文将会介绍SPSS数据预处理如何排序与分列。
一、数据排序
数据排序是很常用的数据预处理方法,可帮助快速发现一些数据分布规律、缺失值、最大值、最小值等。
以图1所示的店铺销售数据为例,我们希望按照客流量、销售额、销售量的数值大小排序数据。
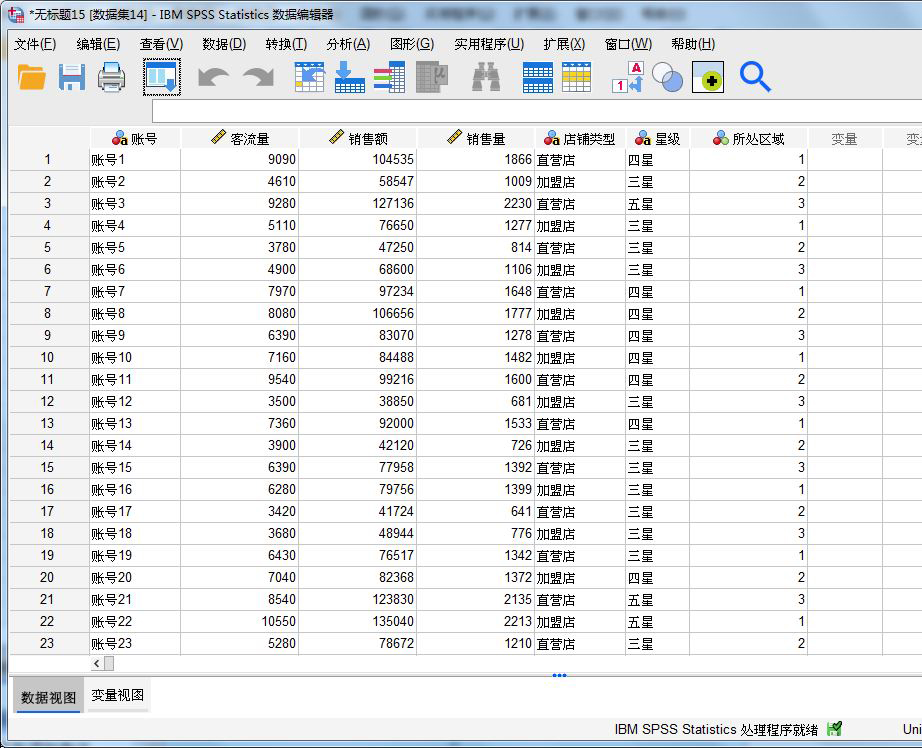
图1:店铺数据 具体的操作是,依次单击IBMSPSSStatistic的数据-个案排序选项。
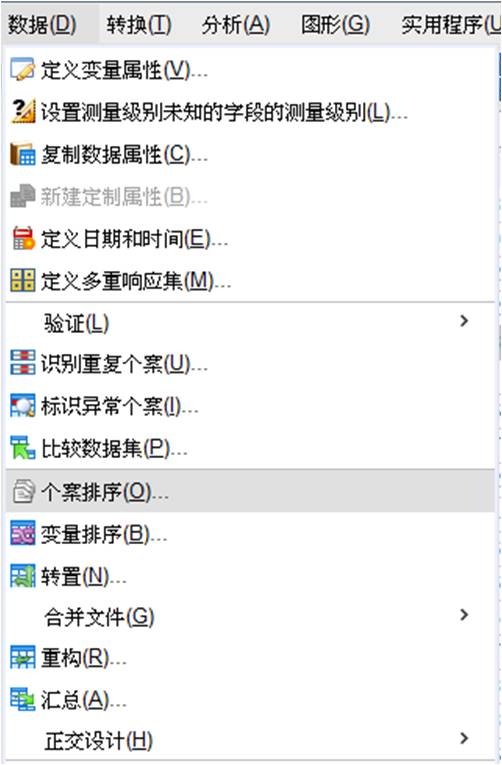
图2:个案排序 在个案排序设置面板中,将客流量、销售额、销售量变量依次添加到排序依据中,变量排位越靠前,越优先用于排序。同时,设置“升序”的排序顺序。
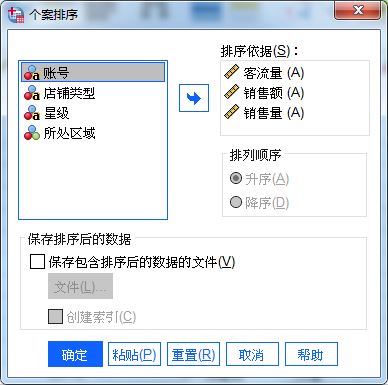
图3:排序依据 完成以上设置后,返回到数据集,即可观察到数据已按照变量的优先次序进行升序排序。同时,我们还能观察到账号118的客流量出现了缺失值。
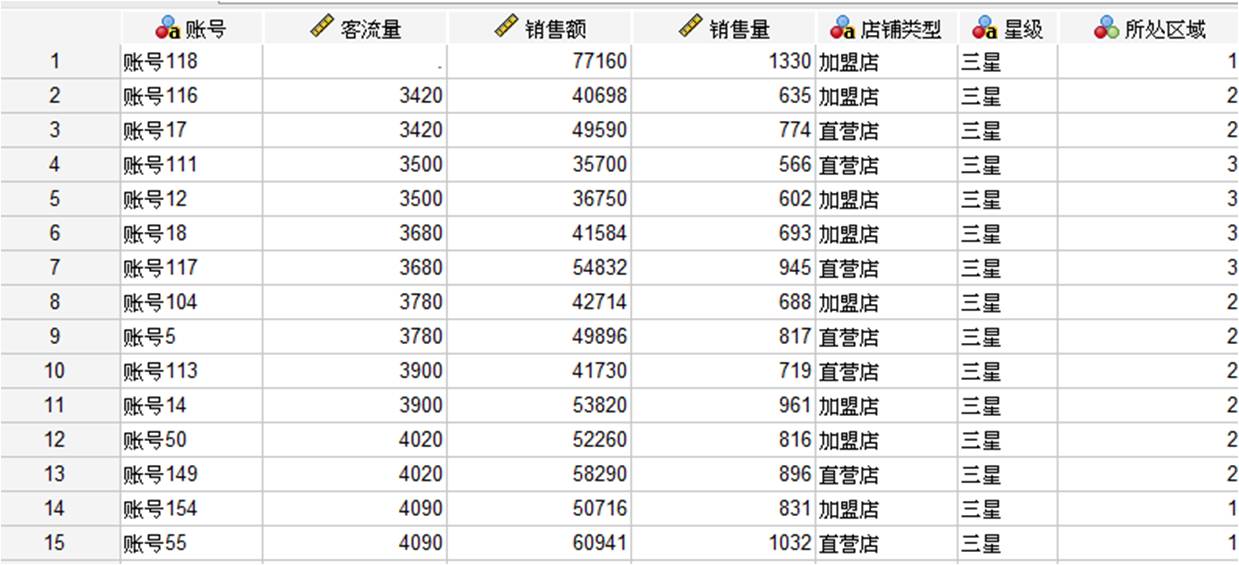
图4:完成个案排序 对于缺失值,可使用IBMSPSSStatistic的“替换缺失值”功能,进行缺失值的计算替换。
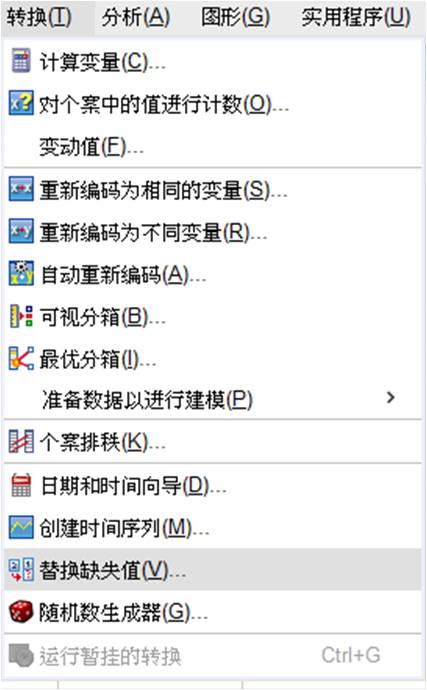
图5:替换缺失值 对于缺失值,可使用序列均值、临近点的平均值、临近点的中间值等方法进行替换值的计算。
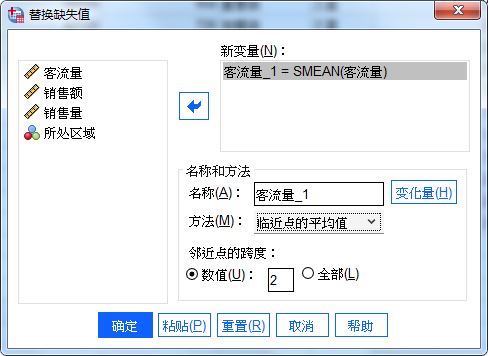
图6:替代缺失值方法 替换值会作为一个新变量添加到原数据集中,我们可根据计算结果判断是否使用该替换值。
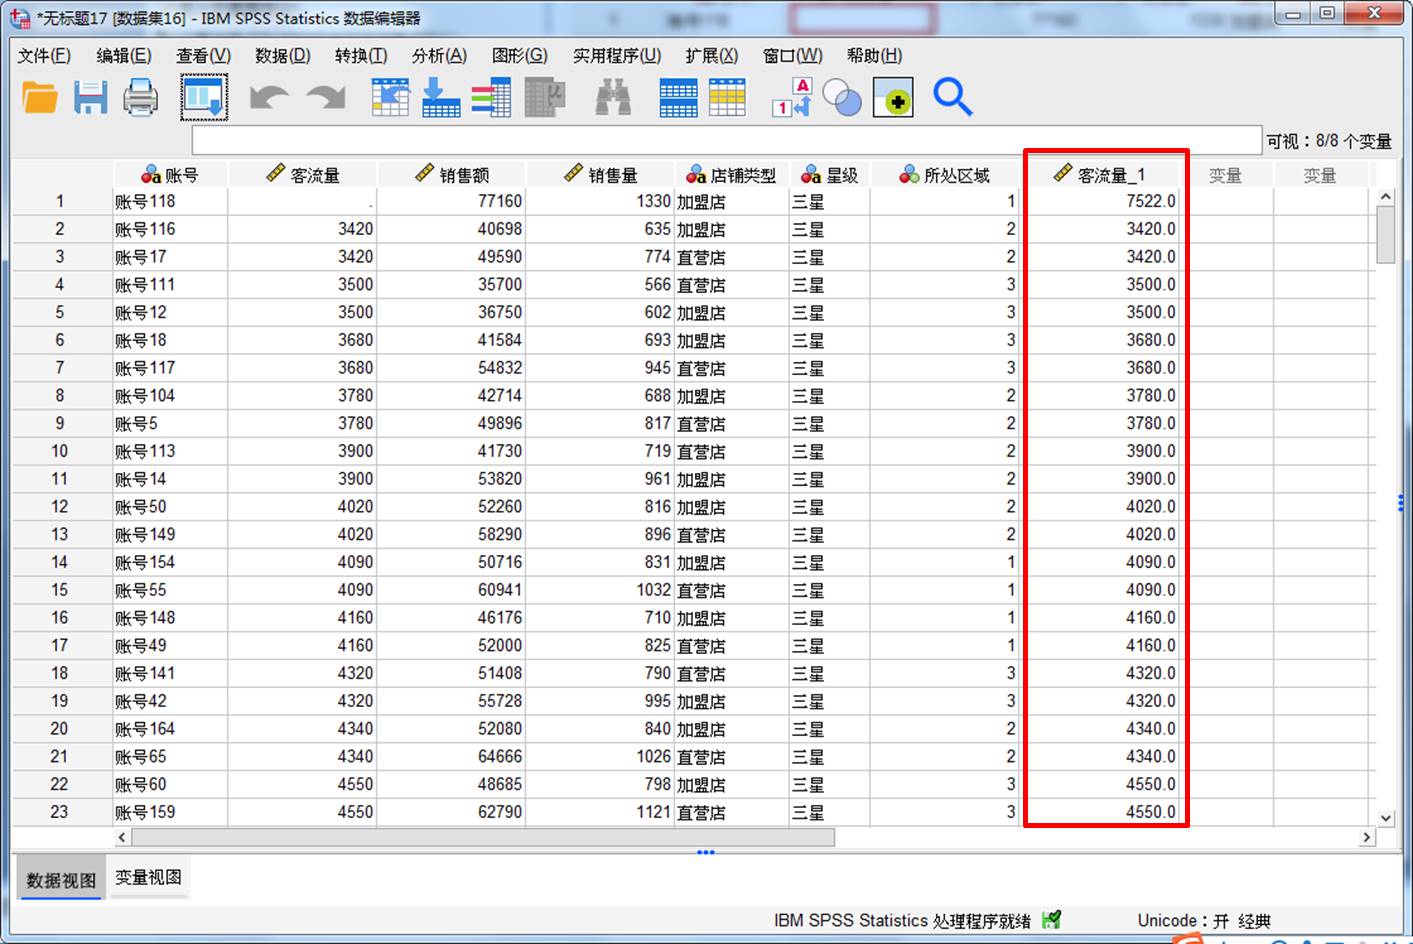
图7:生成新变量 三、数据分列
在处理时间序列数据时,经常会遇到如图8所示的,将年份与月份合并的变量,此时,就可能需要运用到SPPS的分列功能,将变量中的年份与月份数据拆开使用。
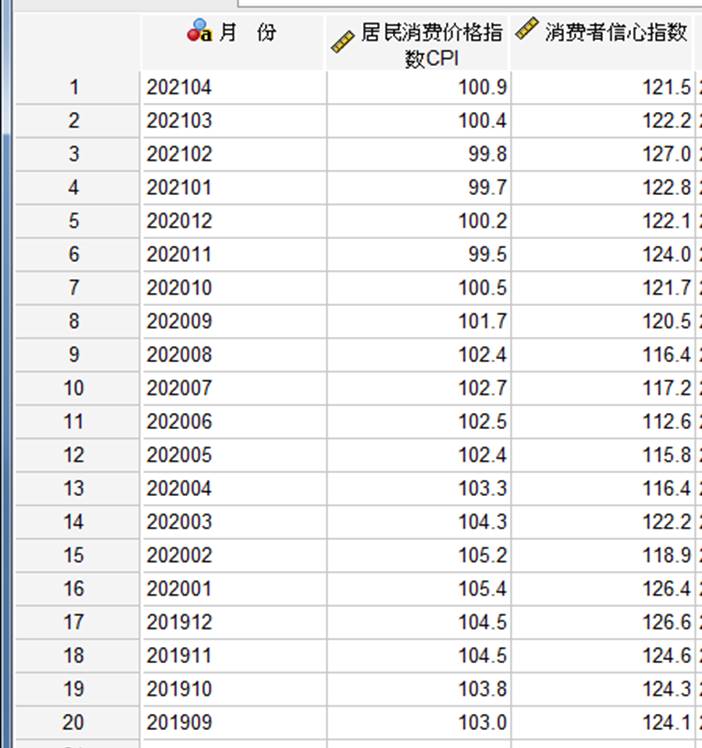
图8:季度CPI数据 与Excel的拆分不同,IBMSPSSStatistic是运用函数进行变量分列的。具体的操作是,依次单击转换-计算变量选项。
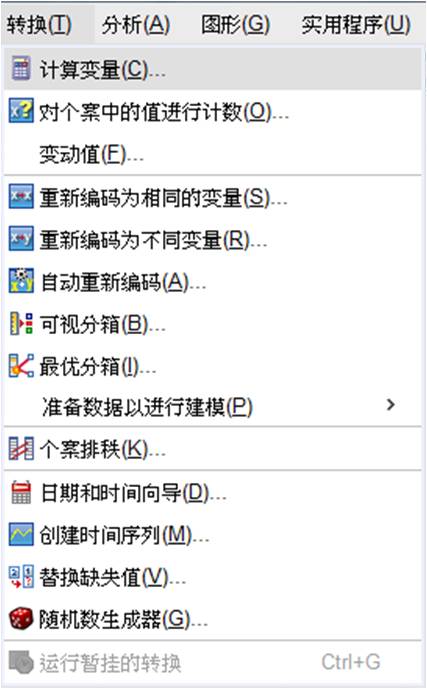
图9:计算变量 如图10所示,在目标变量中输入新分列变量名称,然后再单击其下方的“类型和标签”按钮,将变量类型定义为字符串。这一步很重要,因分列函数仅能识别字符串变量。
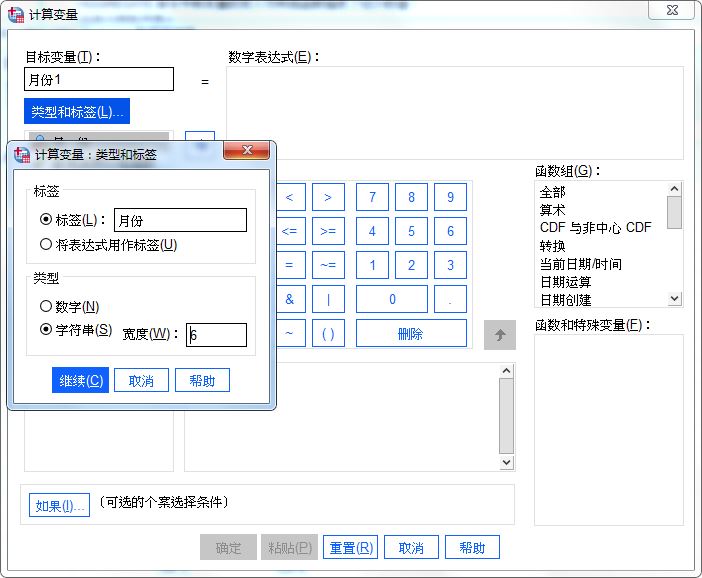
图10:变量类型与标签 然后,如图11所示,在右侧函数中依次选择“字符串”、“Char.Substr”函数。Substr函数可返回特定位置的字符。
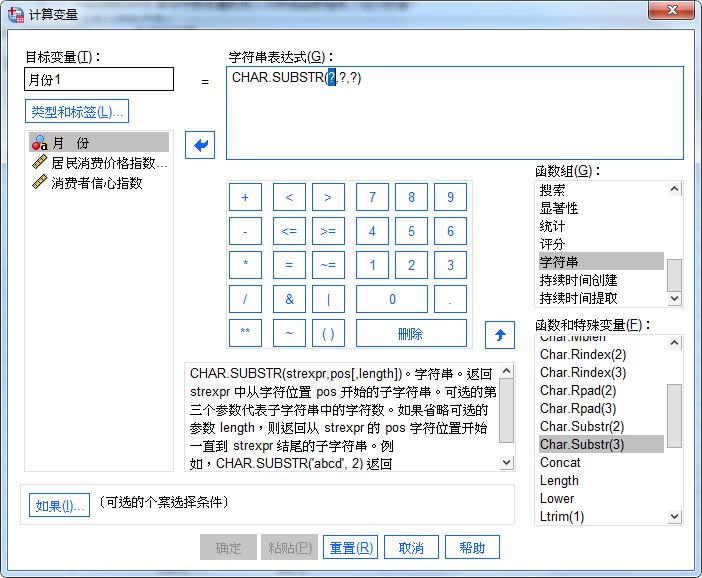
图11:Substr函数 如图12所示,按照函数的参数设置说明,将函数编辑为月份1=Char.Substr(月份,1,4),即可返回原月份变量前4个字符串。
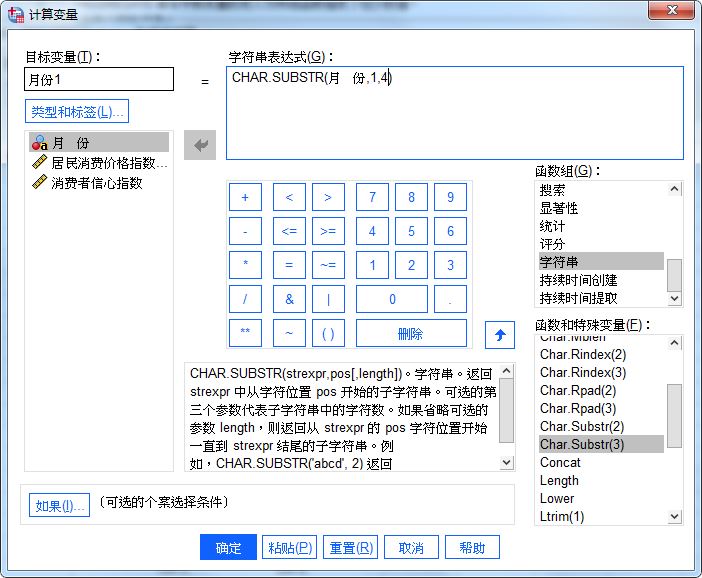
图12:设置函数参数 完成以上设置后,如图13所示,即可在原数据表中得到一个新的变量,将原月份变量的年份数据拆分出来。
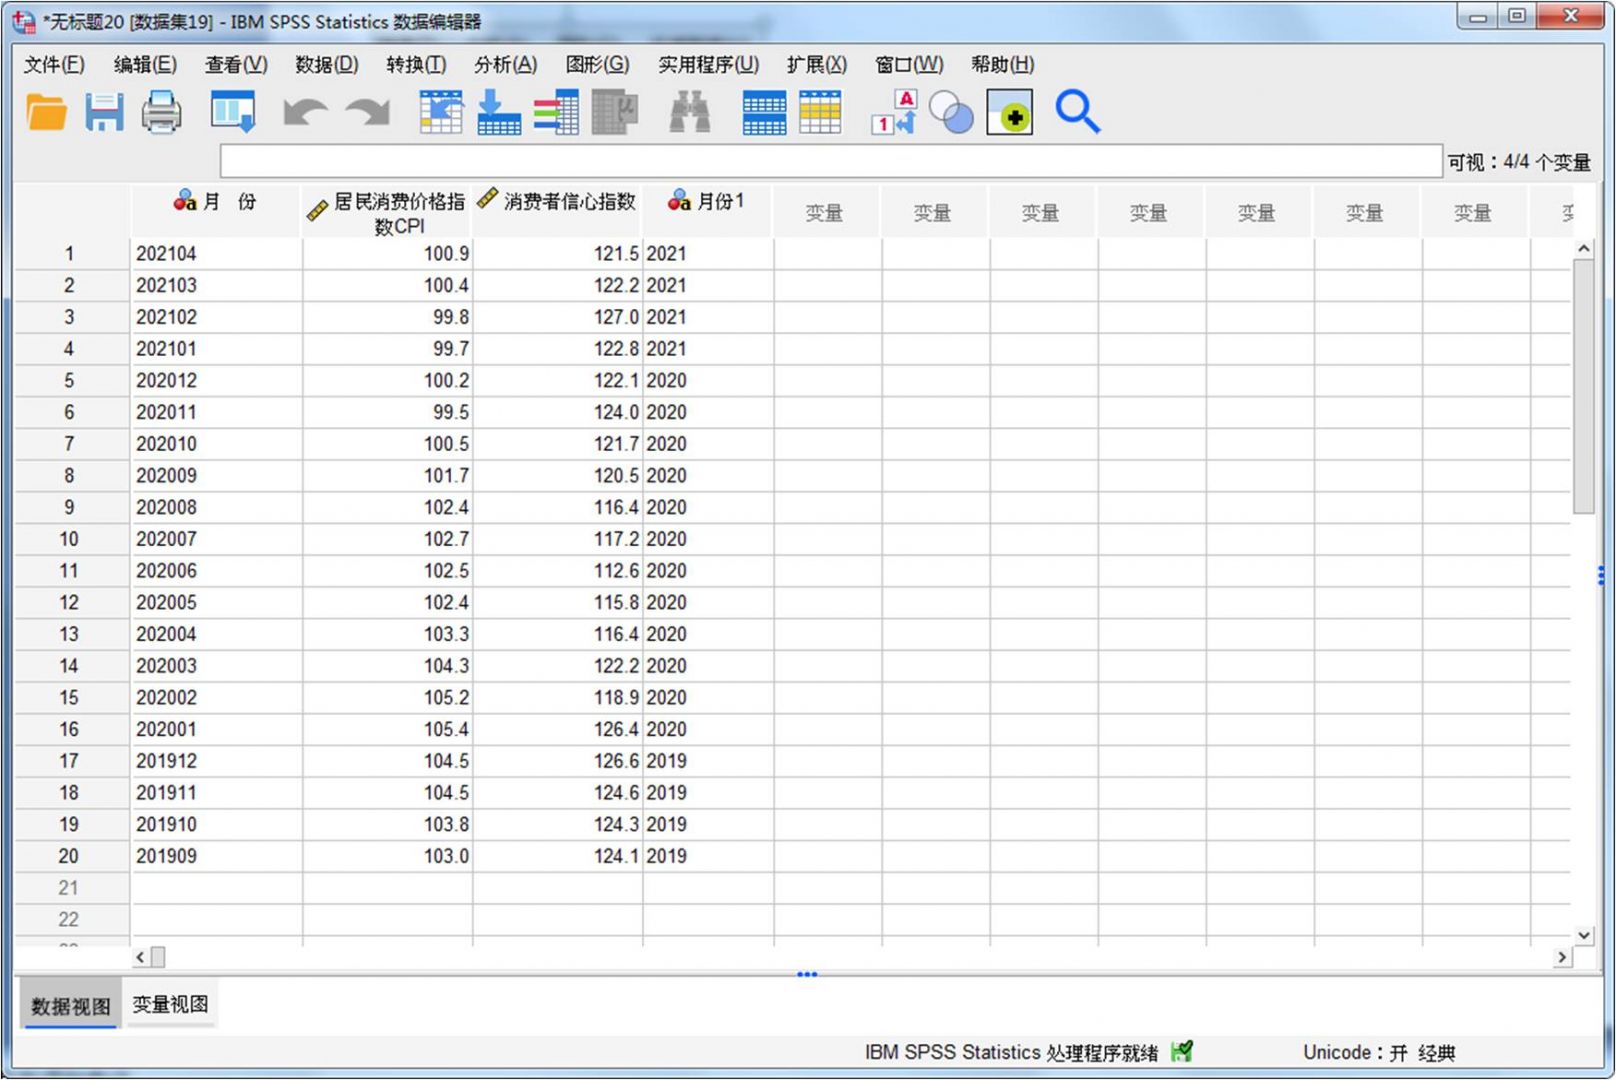
图13:设置函数参数 四、小结
以上就是SPSS数据预处理如何排序与分列的内容了,综上所述,通过使用IBM SPSSS tatistic的个案排序、计算变量功能可实现数据排序、数据分列的预处理操作,以满足不同分析方法的数据形式需求。除此之外,我们还可以使用IBMS PSSS tatistic的重新编码、转置等功能,进行更加高级的数据预处理,如需了解更多的内容,可前往SPSS中文网站。
作者:泽洋
展开阅读全文
︾
标签:SPSS,数据预处理,SPSS数据预处理,SPSS数据排序
读者也访问过这里:热门文章SPSS数据分析显著性差异分析步骤 SPSS显著性差异分析结果怎么看数据的显著性差异分析主要有三种方法,分别是卡方检验、T检验和方差分析。这三种方法都有具体的数据要求:卡方检验是对多个类别的数据进行分析,T检验是对两组数据进行分析,方差分析是对多组数据进行检验。下面,小编具体说明一下SPSS数据分析显著性差异分析步骤,SPSS显著性差异分析结果怎么看。2022-01-07实践SPSS单因素方差分析之检验结果解读在《实践SPSS单因素方差分析之变量与检验方法设置》一文中,我们已经详细地演示了IBM SPSS Statistics单因素方差分析方法的变量选择以及相关的选项、对比设置。2021-01-11spss如何做显著性分析 spss显著性差异分析怎么标abc在统计分析中,显著性分析是分析相关因素之间是否存在显著影响关系的关键性指标,通过它可以说明分析结论是否由抽样误差引起还是实际相关的,可论证分析结果的准确性。下面大家一起来看看用spss如何做显著性分析,spss显著性差异分析怎么标abc。2022-03-14SPSS回归分析中的f值是什么 SPSS回归分析F值在什么范围合适回归分析中以R表示相关性程度的高低,以F评价回归分析是否有统计学的意义,使用IBM SPSS Statistics进行回归分析,可以非常快速的完成R,F的计算,并且给出回归曲线方程,那么,SPSS回归分析中f值是什么?SPSS回归分析F值在什么范围合适,本文结合实例向大家作简单的说明。2022-07-22SPSS多元logistic回归分析的使用技巧回归分析是数据处理中较为常用的一类方法,它可以找出数据变量之间的未知关系,得到较为符合变量关系的数学表达式,以帮助用户完成数据分析。2021-04-26SPSS相关性分析结果怎么看相关性分析是对变量或个案之间相关度的测量,在SPSS中可以选择三种方法来进行相关性分析:双变量、偏相关和距离。2021-04-23最新文章SPSS数据分析显示个案过少怎么办 SPSS如何对个案内的值计数在SPSS中进行数据分析时,有时输出的结果会提示有效个案数不足,这往往是因为变量中存在缺失值,系统自动排除了这些样本。而在处理问卷等多变量数据时,我们也常需要统计同一个案在多个题项中取得某个特定值的次数。接下来我将为大家介绍:SPSS数据分析显示个案过少怎么办,SPSS如何对个案内的值计数的相关内容。2026-10-08SPSS逆模型是什么 SPSS中怎么对逆向指标进行处理逆模型在数据分析领域指两种模型,第一种是逆向建模的逆模型,它是与正模型相对应的一种模型,正模型是通过“输入值”预测“输出值”,逆模型则是通过“输出值”来逆推“输入值”;第二种是倒数模型,即在构建的模型之中使用到的是自变量的倒数,而由此建立起的模型,它通常用于描述随着x的增大,y逐渐逼近渐近线,而使得收益或成本递减的场景,在公共产品领域,边际效益递增或递减的情况十分普遍。本文介绍关于SPSS逆模型是什么,SPSS中怎么对逆向指标进行处理的相关内容。2026-10-0830 天免费试用|IBM Bob,打通 IDE 与命令行的 AI 开发助手IBM Bob 是 IBM 推出的 AI 驱动开发伙伴,能够深入开发人员的代码库,从需求分析、代码编写、项目理解,到测试、调试和应用现代化,全流程辅助软件开发工作,帮助团队更快速地构建高质量软件。2026-09-16什么是SPSS因子载荷值 SPSS公因子方差是因子载荷吗因子分析是数据统计分析中常用的研究方法之一,可以用来实现降维的目的。如果要分析的变量比较多,而变量之间有共性的话,就可以用SPSS的因子分析来减少变量,从而降低数据研究的难度。SPSS的因子分析会提供因子载荷值、碎石图、成分矩阵等运算结果,接下来我们会介绍什么是SPSS因子载荷值,SPSS公因子方差是因子载荷吗的相关内容,让大家可以更熟悉这方面的内容。2026-09-04SPSS公因子方差表怎么看 SPSS公因子方差结果解读我们如果要分析的问题涉及到的变量比较多,可以尝试用因子分析的方法,对变量进行“降维”的处理。降维,实际上就是将影响效果大的变量提取出来,其他影响不大,或者与其他变量相似的,可以剔除出去,这样就能起到减少分析变量的目的。SPSS有成熟的因子分析功能,接下来我们会介绍SPSS公因子方差表怎么看,SPSS公因子方差结果解读的相关内容,让大家可以更熟悉这方面的内容。2026-09-04SPSS个案处理摘要是什么意思 SPSS个案组摘要和各个变量摘要的区别在正式分析数据前,我们可能要对数据的整体情况做一个简单的摸底,比如了解整体的个案数量、是否有缺失值、有效个案数量、均值、标准差等。这些事先的数据摸底,可以让我们更了解数据的分布情况,并对此选择更准确的分析方法。接下来,本文会给大家介绍SPSS个案处理摘要是什么意思,SPSS个案组摘要和各个变量摘要的区别的相关内容。2026-09-04读者也喜欢这些内容:
-
SPSS软件安装与注册试用教程
IBM SPSS Statistics作为一款全球知名的数据统计分析软件,无论是在学术研究领域,还是商业经营领域,都起着举足轻重的作用。其推出的一系列统计分析方法,可用于数据的分析运算、挖掘、模型预测等多个方面。...
阅读全文 >
-
SPSS怎么将数据归一化 SPSS怎么对数据进行可视化
统计学的根本意义就在于将零散、繁多的信息进行多方汇总,并从中抽离出显著的发展规律,借由这些规律看出事物发展的本质。今天我就以SPSS怎么将数据归一化,SPSS怎么对数据进行可视化这两个问题为例,来向大家讲解一下如何在SPSS中进行数据的归一化和可视化操作。...
阅读全文 >
-

SPSS数据透视表好用吗 SPSS数据透视表变量两个值怎么做
从名称上我们就能看出,数据透视表是一种表格形式的数据分析工具。设定完整的数据透视表,不仅能够分析已有数据,还支持数据的动态更新和汇总运算,功能十分强大。今天我就以SPSS数据透视表好用吗,SPSS数据透视表变量两个值怎么做这两个问题为例,来向大家讲解一下SPSS中关于数据透视表的相关知识。...
阅读全文 >
-
SPSS数据转置什么意思 SPSS数据转置怎么操作
在进行SPSS数据计算和分析之前,研究者通常运用SPSS数据转置的方法,借此对繁杂数据进行行列互换,适用于EXCEL、CSV、文本数据、SAS等各类形式的数据文本,便于研究者清晰全面地了解数据信息。本文以SPSS数据转置什么意思,SPSS数据转置怎么操作这两个问题为例,带大家了解一下SPSS数据转置的相关知识。...
阅读全文 >
-

 400-8765-888
 kefu@makeding.com