- 首页
- 产品
- 下载
- 学生专享NEW
-
帮助中心
SPSS自定义多元函数拟合怎么做 SPSS多个自变量拟合怎么做
发布时间:2026-04-22 10: 00: 00
品牌型号:联想拯救者R7000
系统:Windows11家庭中文版
软件版本:IBM SPSS Statistics 27
我们在进行数据分析的过程中,经常会遇到这两种需求:一是已知变量之间的特定非线性关系,需要自定义公式拟合;二是探究多个自变量对因变量的综合影响。在SPSS中,我们可以通过“非线性回归”和“多元线性回归”两种功能,来精准满足这两类需求。接下来我将为大家介绍:SPSS自定义多元函数拟合怎么做,SPSS多个自变量拟合怎么做的相关内容。
一、SPSS自定义多元函数拟合怎么做
自定义多元函数拟合的方法适合已知非线性函数形式的多变量分析。这里我们举一个例子,假设某企业员工的工资=2000+a×年龄+b×教育水平,其中工资为因变量Y,年龄x₁、教育水平x₂为自变量,a和b是固定的系数。我们就可以通过“非线性回归”功能来进行计算。接下来我来为大家介绍相关的步骤。
1、首先,我们要确保因变量、自变量没有严重缺失值或异常值。然后,如下图所示,将数据集录入SPSS中。
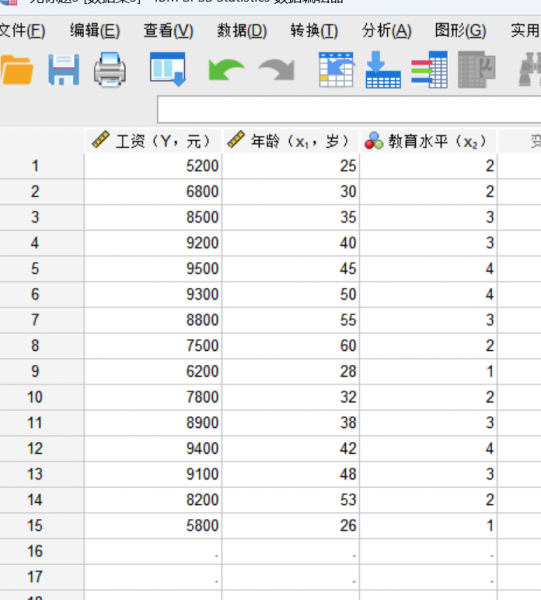
图1:准备数据 2、在SPSS上方的菜单栏中,点击分析-回归,选择其中的非线性,弹出“非线性回归”的菜单。
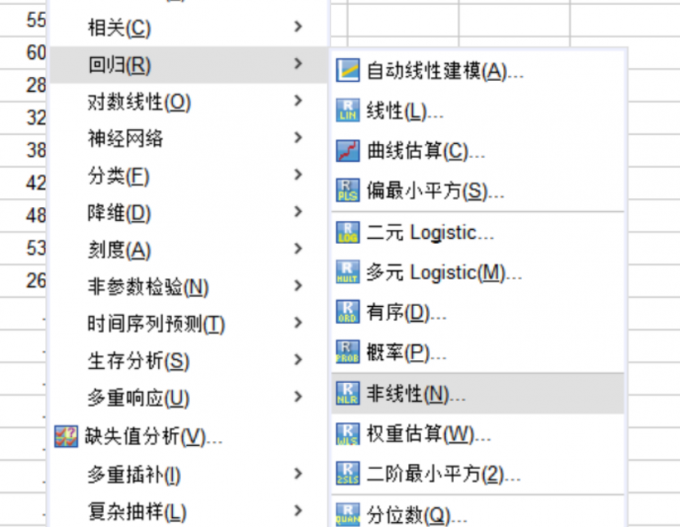
图2:选择非线性 3、在非线性回归的菜单中,我们将工资变量拖入因变量中,然后在“模型表达式”中,输入预设的多元函数公式。输入时需注意:变量名要与SPSS中完全一致,公式符号准确,避免因输入错误导致报错。
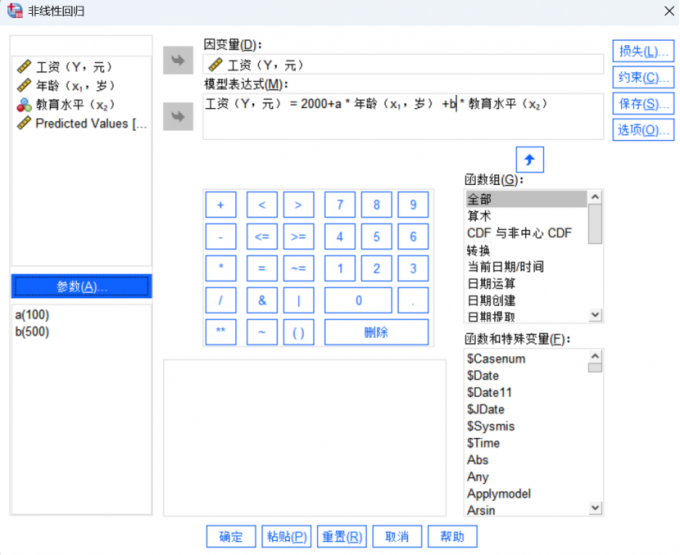
图3:输入表达式 4、点击“参数”按钮,在弹出的菜单中为公式中的未知参数(a、b)设置初始值(合理即可)。其中参数a(年龄影响系数)可设为100(假设年龄每增1岁,工资初步增100元);参数b(教育水平补贴):设500(假设教育水平每升1级,工资增500元)。设置后点击“继续”。
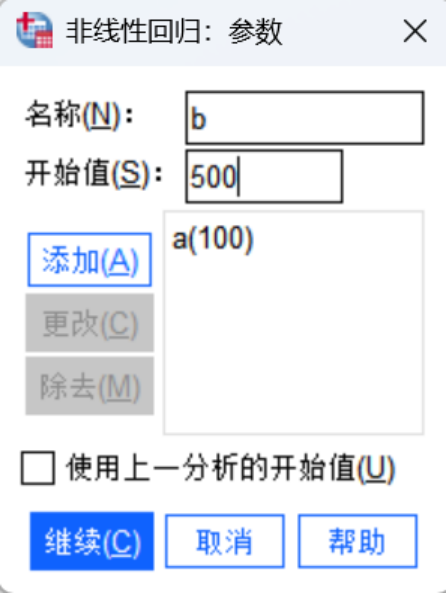
图4:参数设置 5、点击“保存”按钮,我们可以选择是否勾选“预测值”和“残差”。预测值可与实际工资对比;残差可以用于判断拟合效果(残差越小越好)。
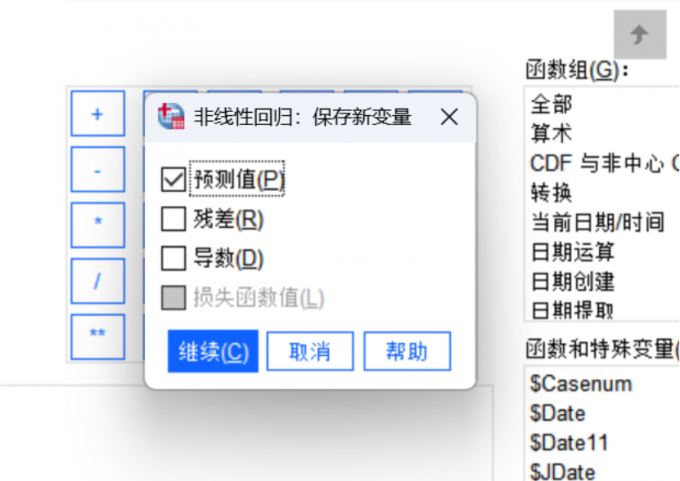
图5:保存新变量 6、点击“确定”,SPSS就会自动运行计算,并生成如下图所示的结果。我们需要重点关注的是:
(1)参数估算值:表格显示a=100.000、b=500.000,且标准错误为0,说明参数拟合稳定;
(2)迭代历史记录:仅1次迭代即收敛(残差平方和稳定),说明模型设置合理;
(3)ANOVA表:回归平方和与修正后总计的比例反映拟合度,结合残差平方和可判断拟合效果。
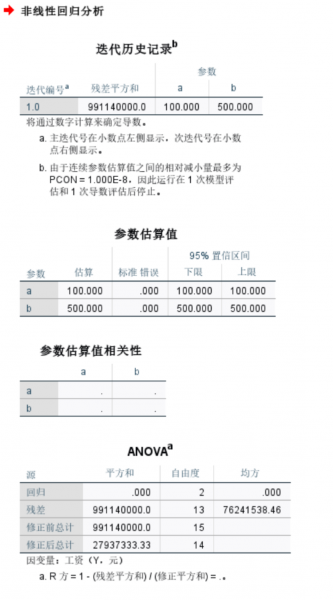
图6:查看结果 以上就是自定义多元函数拟合的相关步骤了,相信大家通过这个清晰明了的例子,再自己实操一次,就能够掌握相关的操作技巧。
二、SPSS多个自变量拟合怎么做
多个自变量拟合分线性和非线性两种场景:线性关系用“多元线性回归”,非线性关系用“自定义多元函数拟合”(也就是我们上文谈到的内容)。下面,我们将为大家讲解常用的多个自变量线性拟合。
1、这里我们采用的例子是:探究学习时间、课堂参与度对学生成绩的影响。首先,我们需确认自变量与因变量均为连续型,且呈线性趋势。如下图所示,共包含了15个有效样本。
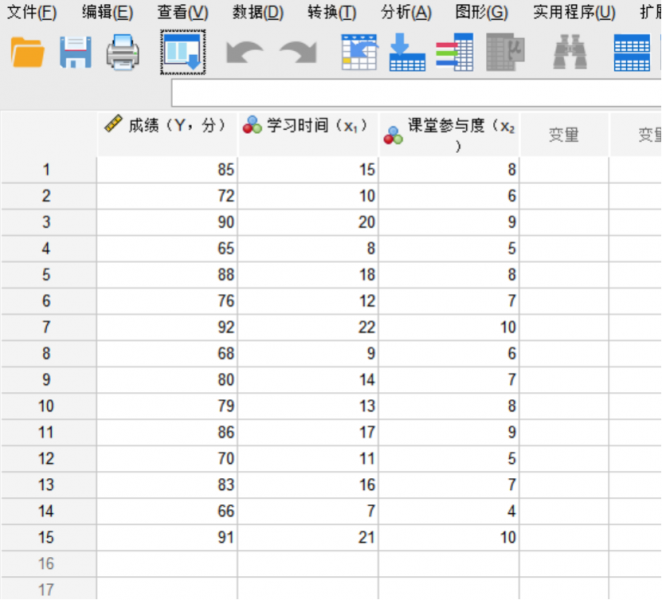
图7:准备数据 2、在SPSS上方的菜单栏中,找到分析-回归,选择其中的“线性”,弹出“线性回归”菜单。
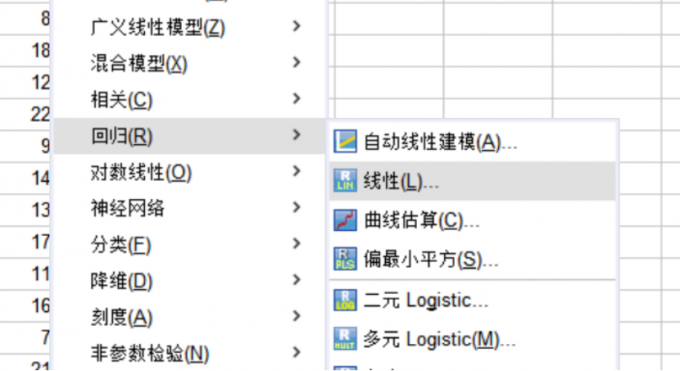
图8:选择线性 3、接着,我们选择因变量与多个自变量,将“成绩”拖入因变量框中,将“学习时间”“课堂参与度”同时拖入自变量框中;方法选择默认的“输入”即可。设置后界面如以下配图所示。
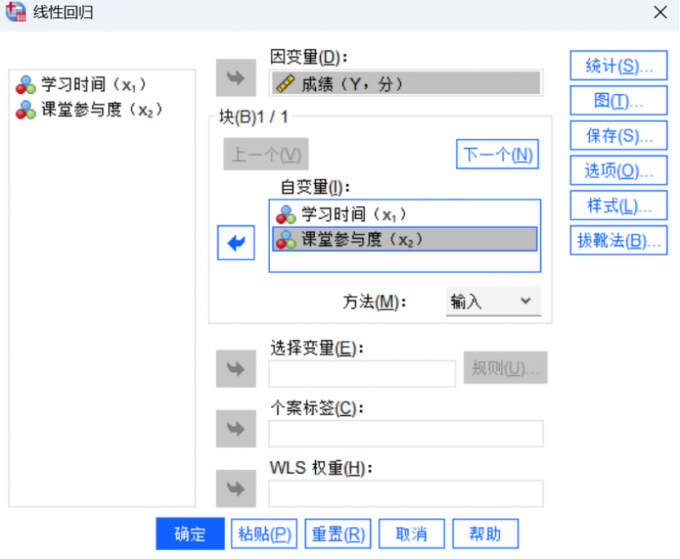
图9:选择变量 4、点击“统计量”,弹出统计设置窗口,我们可以在该菜单中设置回归系数、模型拟合度、共线性诊断等等。直接勾选需要使用到的功能即可,设置后点击“继续”可以返回主对话框。
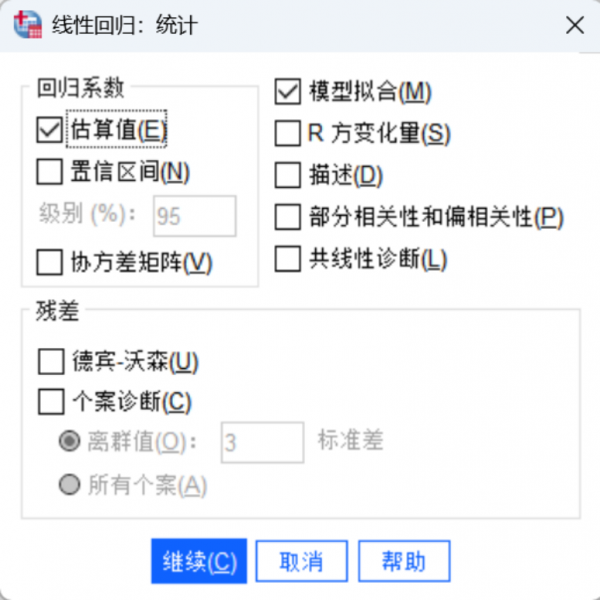
图10:统计设置 5、点击“确定”,SPSS将会自动生成结果,在输出文档中,我们重点关注:
(1)模型摘要:R方=0.964,说明学习时间和课堂参与度能解释96.4%的成绩变化,拟合效果很好;
(2)ANOVA表:显著性<0.001(<0.05),说明多个自变量联合对成绩有显著影响;
(3)共线性诊断:VIF均<10,说明无共线性问题,结果可靠。
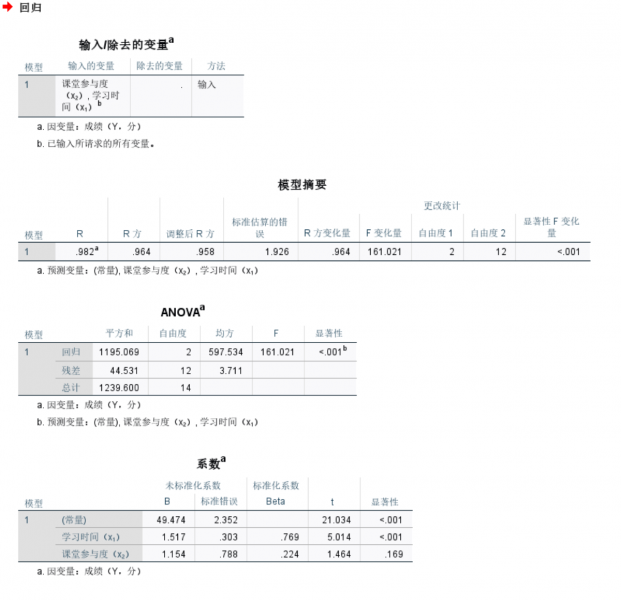
图11:查看输出结果 以上就是SPSS自定义多元函数拟合怎么做,SPSS 多个自变量拟合怎么做的全部内容了。多个自变量拟合需先判断关系——线性用“多元线性回归”,操作简单且需关注共线性;非线性用“自定义多元函数拟合”,需明确函数形式。无论哪种方法,都要先验证数据有效性(无缺失、无异常),再通过参数显著性、模型拟合度和残差分析验证结果。掌握这两类方法,能应对大部分多变量拟合需求,让数据分析更具深度和可靠性。
作者:左旋葡萄糖
展开阅读全文
︾
标签:数据统计分析软件,数据分析软件,SPSS变量,SPSS控制变量
读者也访问过这里:热门文章SPSS数据分析显著性差异分析步骤 SPSS显著性差异分析结果怎么看数据的显著性差异分析主要有三种方法,分别是卡方检验、T检验和方差分析。这三种方法都有具体的数据要求:卡方检验是对多个类别的数据进行分析,T检验是对两组数据进行分析,方差分析是对多组数据进行检验。下面,小编具体说明一下SPSS数据分析显著性差异分析步骤,SPSS显著性差异分析结果怎么看。2022-01-07实践SPSS单因素方差分析之检验结果解读在《实践SPSS单因素方差分析之变量与检验方法设置》一文中,我们已经详细地演示了IBM SPSS Statistics单因素方差分析方法的变量选择以及相关的选项、对比设置。2021-01-11spss如何做显著性分析 spss显著性差异分析怎么标abc在统计分析中,显著性分析是分析相关因素之间是否存在显著影响关系的关键性指标,通过它可以说明分析结论是否由抽样误差引起还是实际相关的,可论证分析结果的准确性。下面大家一起来看看用spss如何做显著性分析,spss显著性差异分析怎么标abc。2022-03-14SPSS回归分析中的f值是什么 SPSS回归分析F值在什么范围合适回归分析中以R表示相关性程度的高低,以F评价回归分析是否有统计学的意义,使用IBM SPSS Statistics进行回归分析,可以非常快速的完成R,F的计算,并且给出回归曲线方程,那么,SPSS回归分析中f值是什么?SPSS回归分析F值在什么范围合适,本文结合实例向大家作简单的说明。2022-07-22SPSS多元logistic回归分析的使用技巧回归分析是数据处理中较为常用的一类方法,它可以找出数据变量之间的未知关系,得到较为符合变量关系的数学表达式,以帮助用户完成数据分析。2021-04-26SPSS相关性分析结果怎么看相关性分析是对变量或个案之间相关度的测量,在SPSS中可以选择三种方法来进行相关性分析:双变量、偏相关和距离。2021-04-23最新文章SPSS重新编码旧值和新值怎么设置 SPSS中重新编码为其他变量怎么办在问卷数据分析中,我们经常会遇到需要把分类变量重新编码成数值、或者对反向题重新计分的需求,比如把性别重新编码成0/1变量、对李克特反向题做5→1转换。SPSS中的“重新编码为不同变量”功能可以帮我们生成新的变量,同时保留原始数据。接下来我将为大家介绍:SPSS重新编码旧值和新值怎么设置,SPSS中重新编码为其他变量怎么办的相关内容。2026-10-08SPSS模型摘要和参数估算值的区别 SPSS模型摘要怎么看数据分析结果SPSS不仅提供了丰富的数据研究分析工具,还能运算出很多有用的数据表格,比如模型摘要、个案处理摘要、参数估计值等。这些表格的作用各不相同,在不同的研究课题中,发挥着重要的作用。理解这些表格的作用,将有助于数据的准确分析,接下来我们会介绍SPSS模型摘要和参数估算值的区别,SPSS模型摘要怎么看数据分析结果的相关内容。2026-10-08SPSS中的QQ图是什么意思 SPSS中PP图和QQ图有什么区别QQ图是判断一组数据是否近似正态分布的可视化工具。它的思路很简单:先把样本数据从小到大排序,再把这些“实测分位数”和理论上同位置的正态分布分位数一一对应画成散点图。如果数据服从正态分布,这些点就会大致落在一条从左下角到右上角的对角线上;如果偏离对角线,就说明分布形态和正态有差距。P-P图和QQ图目的相同,都是检验正态性,但两者坐标轴的含义不同、对异常部位的关注点也不一样。接下来我将为大家介绍:SPSS中的QQ图是什么意思,SPSS中PP图和QQ图有什么区别的相关内容。2026-10-08SPSS怎么输入比值数据 SPSS比值用什么方法计算在SPSS的数据处理过程中,我们经常会遇到需要处理比值的情况。比值数据既可以由两个原始变量相除得到后再进行分析,也可以直接利用SPSS的功能对两个变量进行统计描述。接下来我将为大家介绍:SPSS怎么输入比值数据,SPSS比值用什么方法计算的相关内容。2026-10-08SPSS数据逆向化处理怎么操作 SPSS逆向指标如何正向化对于经常需要与数据分析和处理打交道的小伙伴来说,数据逆向化处理大家应该不会感到陌生。因为在数据分析的过程中,数据指标的增减方向也会影响最终数据结果的判读,但是如果将两个方向相反的指标放在一起进行解读,就会出现错误的数据分析结果(例如将学习的效率与玩游戏频率二者进行解读,就会出现错误的结果)。所以数据逆向化就是将这部分数据进行统一标准的操作(统一将数值转换为数越大越好的指标)。下面以SPSS为例,给大家介绍SPSS数据逆向化处理怎么操作,SPSS逆向指标如何正向化的具体内容。2026-10-08SPSS秩和检验如何选择 SPSS秩和检验效应量应怎样计算对于经常与数据分析打交道的小伙伴来说,想必对秩和检验这个概念并不陌生。秩和检验可以用来比较不同组数据分布位置,它在实际应用中抛开数据原始数值,只关注数据的排序(也就是“秩”),然后比较数据排序的秩和是否存在显著差异。所以在许多数据分析场景中都可以看到秩和检验的应用,例如我们在统计一组存在极值数据的样本时(学生的考试成绩,存在极值,不满足正态分布),可以直接用秩和检验的方式对数据开展稳定分析。下面以SPSS为例,给大家介绍SPSS秩和检验如何选择,SPSS秩和检验效应量应怎样计算的具体内容。2026-10-08读者也喜欢这些内容:
-
SPSS怎么给数据分等级 SPSS怎么给数据加单位
在处理数据的时候,我们可能会想给部分范围数据设置等级,比如分数大于90分的,设置为优秀;分数处于75到90之间的,设置为良好等。在SPSS软件里,我们可以用重新编码的方式,给数据分不同的等级,让其含义更丰富。接下来,本文会给大家介绍SPSS怎么给数据分等级,SPSS怎么给数据加单位的相关内容。...
阅读全文 >
-
SPSS如何进行距离分析 SPSS欧氏距离怎么算
在数据分析的领域中,距离分析是一项常用的分析方法,主要用于分析不同观测值之间的相似性或差异性。例如,我们在分析大学生的就业市场时,就可以采取距离分析的方式,分析影响大学生就业选择的不同观测值,并且对比这些观测值之间是否存在关联以及对学生的就业倾向是否存在影响。而欧氏距离可以看作是空间中两个点位的最短距离,反映了空间范围中两点的距离。下面以SPSS为例,给大家介绍SPSS如何进行距离分析,SPSS欧氏距离怎么算的具体内容。...
阅读全文 >
-
SPSS随机抽样步骤 SPSS随机分组操作步骤
我们在进行统计分析以及实验设计的过程中,随机抽样和随机分组能够保证结果的客观性、可靠性。随机抽样提升样本代表性,而随机分组可消除人为偏差。使用SPSS统计软件,能轻松实现这两项功能。接下来我将为大家介绍:SPSS随机抽样步骤,SPSS随机分组操作步骤的相关内容。...
阅读全文 >
-
SPSS多重共线性怎么看 SPSS如何降低多重共线性
无论是在生活中还是在工作中,分析各种问题时我们都会找到许多原因,例如明天是否会下雨可能会与温度、云量和风速等有关;商品的销售情况与价格、包装、质量和节日有关。生活中我们不必计较原因之间是否有关联,但是在要求精准的商业领域与科研领域,遇到这样的分析情况时,我们都要分析数据的共线性,它描述的是自变量之间的相关关系,如果一个模型中的自变量之间有高度的共线性,就会导致模型失真。本文我们就介绍一下SPSS多重共线性怎么看,SPSS如何降低多重共线性的相关内容。...
阅读全文 >
-

 400-8765-888
 kefu@makeding.com